Etapa 1 / 6
Construye el modelo mental
Comprende Migrate API, sus familias de plugins y las herramientas que convierten una migración en un proceso controlado.
Una migración en Drupal no es simplemente un comando de importación. Es una transferencia controlada de información entre dos modelos que rara vez coinciden en nombres, formatos, identificadores o relaciones. El trabajo técnico importa, pero también las preguntas que lo preceden: ¿qué debe trasladarse, qué podemos descartar, cómo lo representará el destino y cómo demostraremos que el resultado es correcto?
Migrate API proporciona una estructura con la que podemos razonar esa transferencia. Drupal separa la lectura del origen, la transformación de cada valor y la escritura en las entidades de destino. Alrededor de ese pipeline aparecen dependencias, tablas de mapeo, mensajes, ejecución repetible y rollback: la maquinaria menos visible que convierte un script aislado en un proceso observable.
Esta guía es un mapa para aprender esa maquinaria de forma progresiva. Amplía las ideas de la serie sobre migraciones en Drupal y las conecta con artículos prácticos sobre recursos, gestión de datos embebidos y CSV, Google Sheets, debugging y varias API remotas. Puedes leerla de principio a fin o utilizar el selector final para entrar directamente por el problema que necesitas resolver hoy. ¡Happy Hacking!
Índice de contenidos
1. Por qué importan las migraciones en un proyecto Drupal
2. Pensar en migraciones, ETL y pipelines
3. Diseñar la transferencia antes de ejecutarla
4. Construir una caja de herramientas y aprender mediante casos
5. Depurar a partir de evidencias, no de intuiciones
6. Seguir la ruta de aprendizaje sobre migraciones en Drupal
7. Elegir el punto de entrada
8. Recordatorio
9. :wq!
Esta guía sigue una secuencia deliberada, pero el trabajo real de migración rara vez llega en un orden tan cómodo. Puede que estés aprendiendo los fundamentos, planificando una entrega, diagnosticando un fallo o coordinando ya varios sistemas remotos. Utiliza el selector para entrar por el punto que resulte más útil para tu situación actual.
Elijas la ruta que elijas, un mismo modelo mantiene la coherencia del recorrido: comprender el origen, hacer explícita cada transformación y conservar un destino observable. El diagrama ETL nos proporciona ese vocabulario compartido antes de abordar decisiones específicas de Drupal.
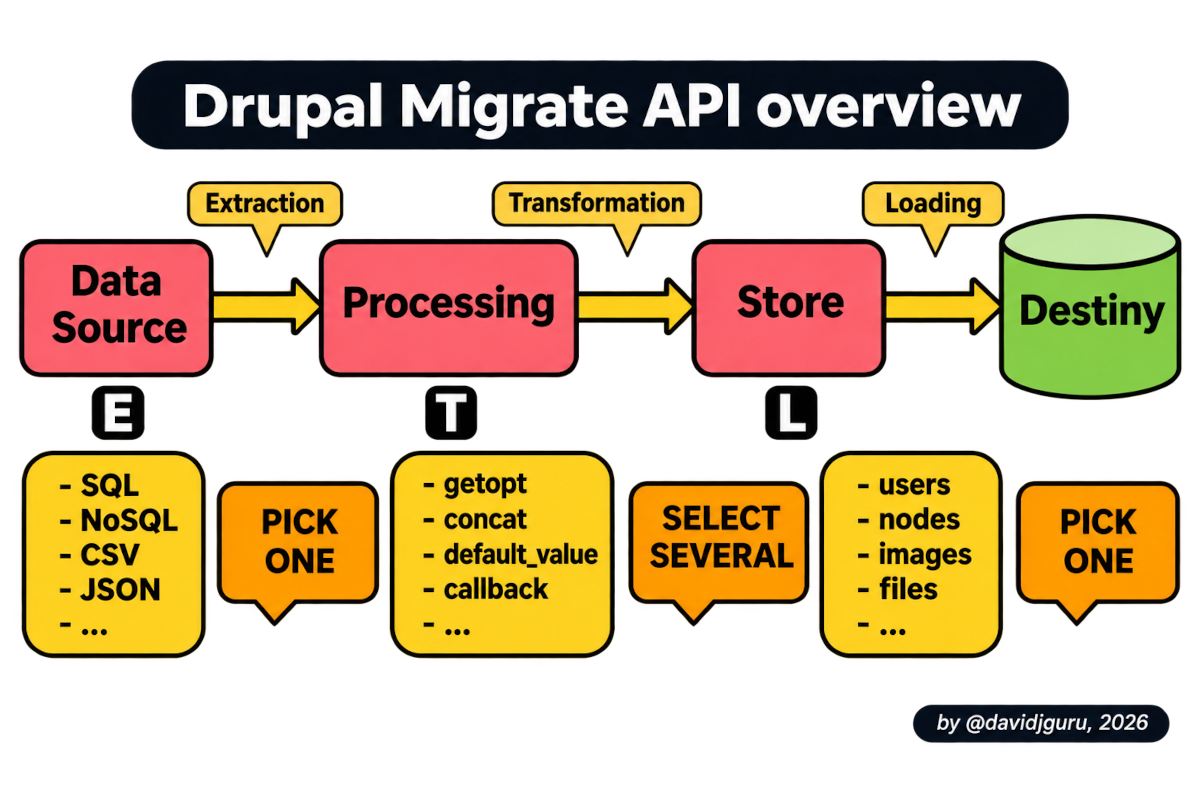 ETL proporciona el modelo mental que sostiene el pipeline de una migración en Drupal.
Los datos existentes suelen decidir si una nueva plataforma Drupal es viable. Una propuesta puede tener un modelo de contenidos sólido, una interfaz editorial capaz y una arquitectura técnica convincente, pero seguirá incompleta hasta que alguien responda a una pregunta engañosamente sencilla: ¿qué ocurrirá con la información que ya sostiene a la organización? Conocer las migraciones nos permite responder con algo más creíble que «ya escribiremos un script más adelante».
Una migración es, por tanto, un proceso técnico y una capacidad de proyecto. Trasladar información desde un CMS legacy, una versión anterior de Drupal, una hoja de cálculo o un conjunto de servicios remotos exige análisis, diseño, implementación y validación. Puede involucrar al equipo de desarrollo, especialistas de contenido, responsables de proyecto y personas que conozcan el origen lo suficiente como para explicar sus excepciones. Tratar este trabajo como una importación final oculta esa responsabilidad compartida.
Los artículos originales sobre migraciones que sostienen esta guía presentan ese conocimiento como algo que beneficia al profesional, al proyecto y a la organización al mismo tiempo. La idea sigue siendo relevante más allá de Drupal 8: un equipo capaz de inventariar información, modelar transformaciones y explicar un plan de ejecución reversible está mejor preparado para justificar sus decisiones de arquitectura y reducir la incertidumbre durante toda la entrega.
En su sentido más amplio, una migración mueve información de software desde un origen hasta un destino mientras resuelve sus diferencias. Eso es todo. Esa es la esencia de un proceso ETL: Extract, Transform, Load.
El origen puede ser una base de datos relacional, ficheros CSV, respuestas JSON, una hoja de Google, otra instalación Drupal o incluso una aplicación construida con tecnologías diferentes.
El destino puede contener nodos, términos de taxonomía, usuarios, ficheros, media, paragraphs, configuración o entidades de contenido personalizadas.
En el proceso que conecta ambos se encuentra el verdadero trabajo: decidir qué significa cada valor del origen dentro del nuevo modelo.
ETL nos ofrece un vocabulario duradero para ese trabajo: Extract, Transform and Load. La extracción obtiene filas del origen; la transformación limpia, combina, normaliza o deriva valores; y la carga persiste el resultado en su destino. No es terminología exclusiva de Drupal, y precisamente por eso resulta útil: nos permite hablar del flujo de información antes de elegir módulos, comandos o plugins concretos.
Drupal traduce ETL en plugins de origen, proceso y destino. Una migración suele seleccionar un plugin de origen que produce filas, encadenar uno o varios plugins de proceso para cada propiedad de destino y utilizar un plugin de destino para crear o actualizar el objeto final. La salida de un paso puede convertirse en la entrada del siguiente, de modo que la capa de transformación se comporta como un pipeline y no como una lista plana de asignaciones.
Parafraseando el artículo formativo original, el modelo básico se compone de definición más (+) ejecución, mientras que el modelo ampliado añade el comportamiento del pipeline, los grupos de migración y las dependencias. La definición YAML describe la intención, pero el estado en runtime nos cuenta qué se importó, qué identificadores de origen corresponden a los de destino, qué falló y si una migración posterior puede reutilizar con seguridad el resultado de otra anterior.
Finalmente, también podríamos decir que el modelo básico se reduce en esencia a tres pasos: definición + ejecución + debugging.
Una migración fiable comienza con un inventario, no con YAML. Enumera los datasets de origen, identificadores estables, relaciones, idiomas, ficheros y registros excepcionales. Describe después las entidades, bundles, campos y reglas de validación del destino. Esta comparación descubre pronto los huecos: una columna puede no tener destino, un campo obligatorio de Drupal puede no tener un valor de origen o una relación puede depender de contenido que debe migrarse antes.
El modelo de destino debe dirigir la estrategia de transformación. Un título puede mapearse directamente, pero las fechas quizá necesiten procesamiento, los nombres de términos pueden requerir una búsqueda de entidades, los ficheros pueden necesitar una migración separada y las estructuras embebidas quizá tengan que convertirse en paragraphs o entidades personalizadas. Diseñar estas operaciones como transformaciones explícitas permite revisarlas y evita que las reglas de negocio desaparezcan dentro de un importador improvisado.
Las dependencias convierten una colección de importaciones en un plan de migración ordenado. Los usuarios, ficheros o términos de taxonomía suelen tener que existir antes de que los nodos puedan referenciarlos; los registros padre pueden tener que preceder a sus hijos; y los identificadores remotos deben seguir siendo trazables después de la carga. Los grupos de migración y los plugins de lookup expresan esas relaciones, mientras que las tablas de mapeo y mensajes aportan la memoria operativa necesaria para ejecutar y diagnosticar de forma incremental.
Código frente a configuración es una decisión de diseño, no una simple diferencia de ubicación. Ambos enfoques pueden usar YAML, pero tienen ciclos de vida, implicaciones de despliegue y flujos de edición diferentes. La pregunta importante es qué modelo hace que la migración sea repetible, revisable y segura para el equipo que debe operarla. El segundo artículo de la serie compara ambos enfoques mediante ejemplos con datos embebidos y CSV, en lugar de tratar la elección como una preferencia abstracta.
Antes de empezar la implementación conviene convertir ese trabajo de diseño en preguntas que todo el equipo pueda responder. Esta breve checklist hace visibles los supuestos ocultos cuando todavía resulta barato discutirlos.
Cuando esas seis respuestas son explícitas, YAML expresa un modelo acordado en lugar de convertirse en el lugar donde el modelo se inventa por accidente. Ya podemos pasar de la planificación a la caja de herramientas y a casos progresivamente más realistas.
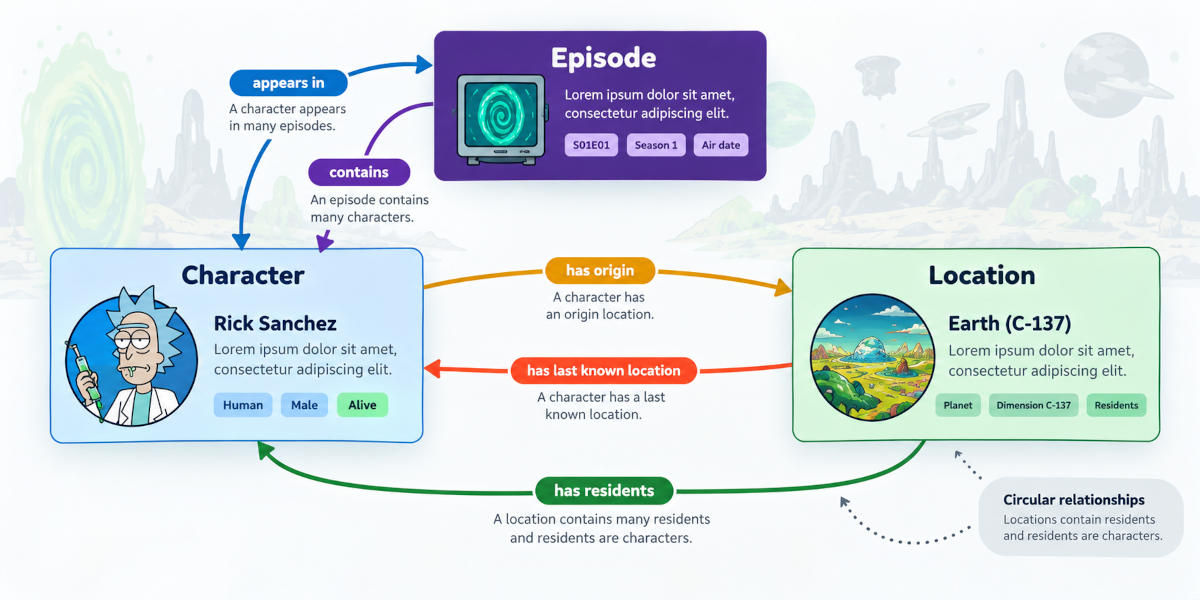 Una migración supera el mapeo de campos cuando confluyen varias fuentes y relaciones entre entidades.
Drupal core proporciona el framework de migración; los módulos contribuidos permiten operarlo en la práctica. Migrate aporta la API base y el sistema de plugins, mientras que las herramientas habituales a su alrededor añaden definiciones, comandos, formatos de origen o soporte para debugging. Los nombres y la compatibilidad de los módulos pueden cambiar entre versiones de Drupal, por lo que el primer artículo explica el ecosistema y remite a recursos que deben comprobarse para la versión utilizada por cada proyecto real.
Una caja de herramientas solo resulta útil cuando conectamos cada pieza con un problema. Los plugins de origen responden «¿cómo leo esto?», los plugins de proceso responden «¿cómo lo convierto en el valor que Drupal espera?» y los plugins de destino responden «¿qué clase de objeto estoy escribiendo?». Los comandos de Drush exponen después los flujos de estado, importación, rollback y mensajes. Mantener separadas esas responsabilidades permite sustituir una parte sin reescribir toda la migración.
La ruta de aprendizaje crece deliberadamente desde ejemplos controlados hasta integraciones realistas. Las filas embebidas como escenario base eliminan la incertidumbre externa; CSV introduce un fichero de origen; Google Sheets añade una transformación remota; los artículos de debugging exponen el estado en runtime; y el proyecto con varias API combina entidades, relaciones y enriquecimiento. Esta ruta progresiva, iterativa e incremental procede directamente de la estrategia educativa del borrador de trabajo: cada caso debe reutilizar el modelo mental anterior y añadir una fuente de complejidad significativa.
La mayoría de los fallos de una migración se resuelven mejor cuando reducimos el espacio de búsqueda. Empieza por revisar los datos de origen y la definición de la migración: identificadores, nombres de campos, configuración de plugins, propiedades de destino y supuestos sobre formatos. Inspecciona después el estado, las tablas de mapeo y los mensajes de la migración. Estas capas suelen revelar si el problema apareció al leer, transformar o cargar una fila.
El síntoma que puedes observar suele bastar para elegir la primera capa útil de debugging. Selecciona la descripción más cercana para evitar recurrir a breakpoints antes de dar a los datos, la definición, los mapas y los mensajes la oportunidad de explicar el problema.
La recomendación es un punto de partida, no un sustituto de reducir el caso. Una vez elegida la ruta, ejecuta el subconjunto representativo más pequeño y sigue una sola fila a través del pipeline.
El siguiente nivel consiste en observar los valores que atraviesan el pipeline. Las herramientas de debugging y los plugins de proceso pueden exponer propiedades de origen y destino en un punto controlado, mientras que ejecutar un subconjunto pequeño mantiene legible la señal. Resulta más útil que importar repetidamente todo el dataset porque vincula un resultado inesperado con una fila y una transformación concretas.
Xdebug es el último nivel cuando la configuración y las evidencias en runtime no bastan. Los breakpoints permiten seguir el descubrimiento de plugins, la preparación de filas, la ejecución del proceso y la gestión del destino dentro de PHP. El artículo relacionado describe el debugging como una escalera —datos y definiciones, estado de la base de datos y feedback, y finalmente código—, que es también el principio organizador de los artículos cuarto y quinto de esta guía.
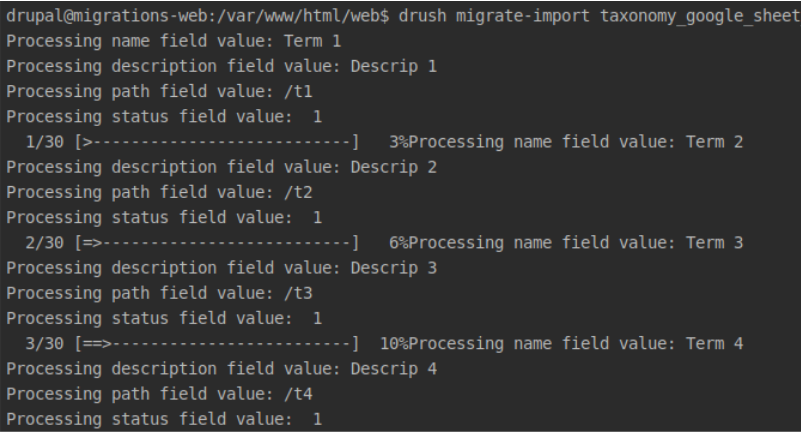 El feedback conecta una fila de origen, sus valores transformados y el resultado de destino.
Seis artículos, seis niveles de confianza y una ruta en la que puedes entrar desde cualquier punto. Recorre el itinerario desde los fundamentos hasta la arquitectura de integración o salta directamente a la etapa que encaje con el problema que tienes delante. Cada parada te explica qué podrás hacer después, no solo qué vas a leer.
Elige tu próximo movimiento
Selecciona una etapa para descubrir la capacidad que vas a desarrollar. La ruta es secuencial, pero el problema que tienes hoy decide el punto de partida.
Etapa 1 / 6
Comprende Migrate API, sus familias de plugins y las herramientas que convierten una migración en un proceso controlado.
Etapa 2 / 6
Pasa de los conceptos a migraciones funcionales con datos embebidos y CSV, incluyendo ejecución y rollback.
Etapa 3 / 6
Sigue los datos de Google Sheets hasta Drupal y observa cómo el formato de origen transforma los valores antes de llegar a Migrate.
Etapa 4 / 6
Utiliza definiciones, tablas de mapeo, mensajes y Migrate Devel para localizar el punto exacto donde el resultado se desvía.
Etapa 5 / 6
Conecta Xdebug, DDEV y PhpStorm para observar con breakpoints el descubrimiento de plugins, el proceso y la escritura en destino.
Etapa 6 / 6
Trata la migración como arquitectura de integración combinando fuentes remotas, entidades personalizadas y relaciones trazables.
Consejo: utiliza las flechas del teclado para recorrer la ruta.
Si estás aprendiendo, sigue la secuencia desde los conceptos hasta la complejidad. Empieza por los recursos, reproduce el ejemplo con datos embebidos, introduce CSV y pasa solo entonces a fuentes remotas. Ese orden permite identificar cada nuevo problema: primero la mecánica, luego la variabilidad del origen, después el debugging y finalmente las relaciones entre varias API.
Si ya eres responsable de una migración que falla, entra por la ruta de debugging. Empieza por el cuarto artículo, reduce la ejecución a un caso pequeño y reproducible y pasa a Xdebug solo después de comprobar la definición, los datos, los mapas y los mensajes. Vuelve a los ejemplos cuando necesites aislar un patrón concreto de origen o proceso.
Si estás diseñando un proyecto real, utiliza esta página como lista de comprobación para orientar las conversaciones. Pregunta qué debe trasladarse, qué identificadores son estables, cómo se relacionan las entidades, qué puede revertirse, cómo validará el equipo los resultados y qué supuestos dependientes de la versión necesitan confirmación. Los ejemplos recorren diferentes momentos de la evolución de Drupal; la lección duradera es el método, mientras que los comandos y la compatibilidad siempre deben verificarse contra la plataforma de destino.
Una buena migración deja algo más que contenido importado. Entrega al equipo un modelo explícito del origen, un conjunto revisable de transformaciones y evidencias suficientes para explicar cómo llegó cada registro importante hasta Drupal. Ese entendimiento compartido convierte el código de migración en conocimiento del proyecto.
La ruta más segura es progresiva, repetible y observable. Empieza con un dataset pequeño, conserva identificadores estables, valida las relaciones y añade complejidad únicamente cuando el paso anterior pueda importarse, inspeccionarse y revertirse. Todos los artículos y recursos de esta guía son ensayos diferentes de esa misma disciplina.
El siguiente paso útil es aquel que puedes verificar. Elige el artículo más cercano a tu problema actual, reproduce su caso funcional más pequeño y vuelve a este mapa cuando el modelo de origen o de destino deje de estar claro. Una migración se vuelve manejable cuando sus decisiones dejan de ser implícitas.
Llegados a este punto, seguir leyendo aporta menos que elegir una acción capaz de producir evidencias. El selector final ofrece dos salidas deliberadamente distintas: consolidar los fundamentos o llevar un fallo existente a un workflow de debugging estructurado.
Ambas rutas regresan a la misma disciplina: hacer que el trabajo sea observable, repetible y reversible. Elige la que responda a tu riesgo actual y vuelve a este hub cuando aparezca la siguiente capa de complejidad.
Recibe artículos sobre Drupal y desarrollo web directamente en tu bandeja de entrada.
Comments
Los comentarios los proporciona Disqus. Solo se cargan si permites la categoría de comentarios en tus preferencias de cookies.