Migraciones en Drupal (VI): la experiencia Rick and Migraty, combinando datos de distintas fuentes
En los artículos anteriores de esta serie he explorado la API Migrate de Drupal desde distintos ángulos: primero como una caja de herramientas, después mediante ejemplos sencillos con datos incrustados y archivos CSV, más tarde con una hoja de cálculo de Google expuesta como JSON y, finalmente, dando un paso atrás para depurar el proceso cuando la realidad empieza a dar guerra. Porque siempre acaba dando guerra.
Esta sexta entrega vuelve al lado práctico de la migración de datos: poblar Drupal con datos remotos y estructurados obtenidos de varias API. El objetivo no es construir de una sentada la migración más espectacular del mundo, sino diseñar un proceso lo bastante sencillo para entenderlo y lo bastante complejo para resultar realmente útil.
¿Qué demuestra esto sobre Drupal? Que puede incorporar datos de varias API a un modelo de contenido estructurado, conservar las relaciones entre registros y convertir ese modelo en páginas que las personas puedan recorrer y consultar. Para quienes desarrollan directorios, catálogos u otros sitios que combinan datos externos, la experiencia Rick and Migraty ofrece un ejemplo práctico con la API Migrate, entidades de contenido personalizadas y Views. El repositorio enlazado y la configuración de DDEV permiten ejecutar el proyecto en local y examinar cómo encajan esas piezas.
Para conseguirlo, nos conectaremos a API externas, abiertas y de acceso gratuito. Recursos como la API de Rick and Morty, la API de TVmaze y la wiki de Rick and Morty en Fandom nos proporcionarán los datos necesarios para poblar nuestras entidades de Drupal con personajes, localizaciones, episodios, puntuaciones y descripciones.
La API de Rick and Morty será nuestra fuente principal y proporcionará las entidades básicas y sus relaciones. TVmaze se unirá a la fiesta como fuente secundaria de enriquecimiento, aportando puntuaciones de episodios que integraremos en las entidades de Drupal existentes. Por último, Fandom contribuirá con descripciones narrativas, detalles biográficos y otra información contextual, para construir perfiles más ricos de los personajes y lugares de nuestro universo animado favorito.
Nota: A fecha de 14 de octubre de 2026, la versión original de este artículo supera los 52.000 caracteres y ronda las 10.000 palabras, con un tiempo de lectura estimado de entre 50 y 60 minutos.
Fotografía de Unsplash, del usuario Julian Kraus, @juliankraus
Índice de contenidos
0. TL;DR (solo quiero jugar con Drupal)
1. De dónde salió la idea (orígenes)
2. Qué buscamos (objetivos)
3. Analizar los datos (comprender)
4. Algunas restricciones iniciales (espera)
5. Contenedores de destino en Drupal (entidades)
6. Diseñar la migración (cocinar)
7. Definir plugins de migración (soluciones)
8. Más información de las fuentes (enriquecimiento)
9. De los datos al contenido (navegar)
10. La migración como operación (ejecutar)
11. Perder la cabeza (depurar)
12. Decisiones que merece la pena destacar (decidir)
13. Qué he aprendido (reflexionar)
14. Próximos pasos (planificar)
15. :wq!
0. TL;DR (solo quiero jugar con Drupal)
Vale, vale, no te juzgo. Asegúrate de cumplir los requisitos previos del proyecto:
- Tener Git instalado en tu equipo (git v2.43.0).
- Tener DDEV instalado (ddev v1.25.4, Docker v29.9.0).
- Disponer de una terminal de Linux.
Una vez comprobado todo, sigue estos pasos:
git clone https://gitlab.com/davidjguru/rick-and-migraty.git
cd rick-and-migraty/
ddev start
ddev composer install
Con ello habrás configurado el proyecto en tu entorno de desarrollo local (LDE) utilizando DDEV. Ahora vamos a preparar la instalación de Drupal:
ddev drush site:install --existing-config \
  --account-name=admin \
  --account-pass=admin \
  -y
ddev launch
Así se completará la configuración del sitio y se abrirá el proyecto en tu navegador, en https://rick-and-migraty.ddev.site:
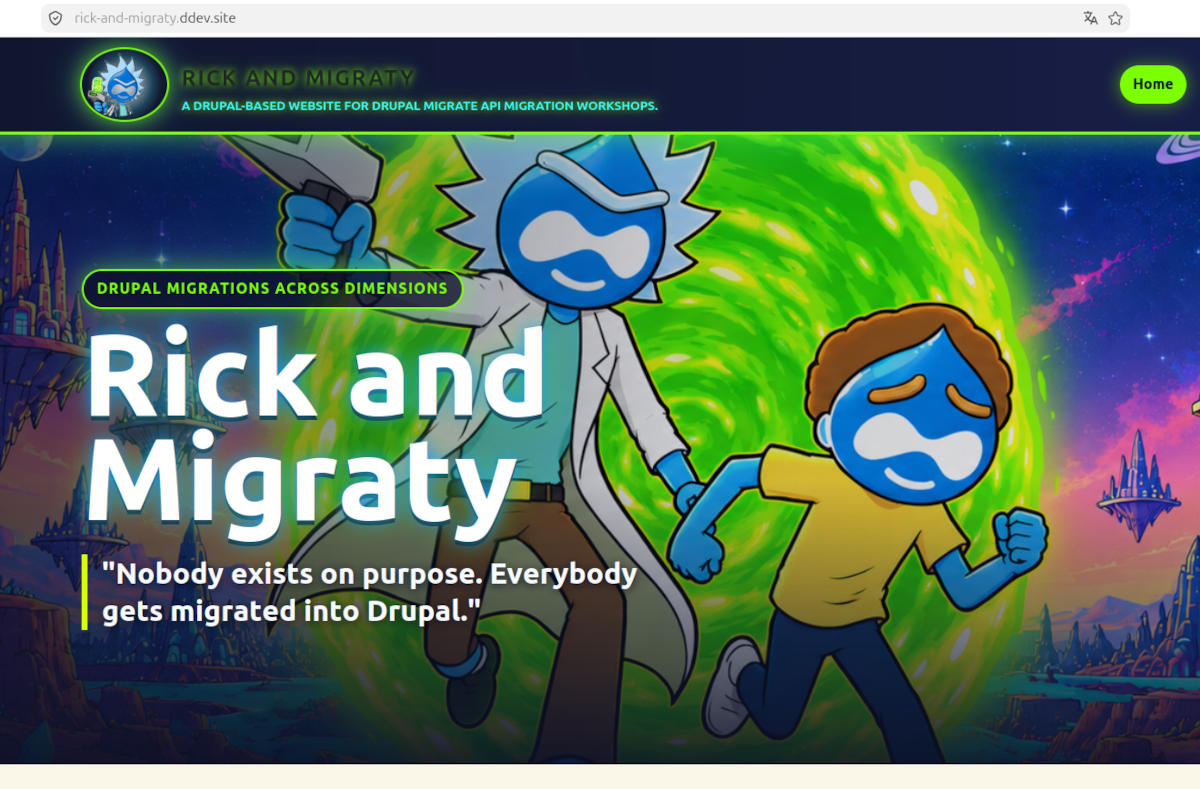 Vista principal de Rick and Migraty en el navegador
Lo que realmente importa en la portada son las acciones que permite realizar el proyecto:
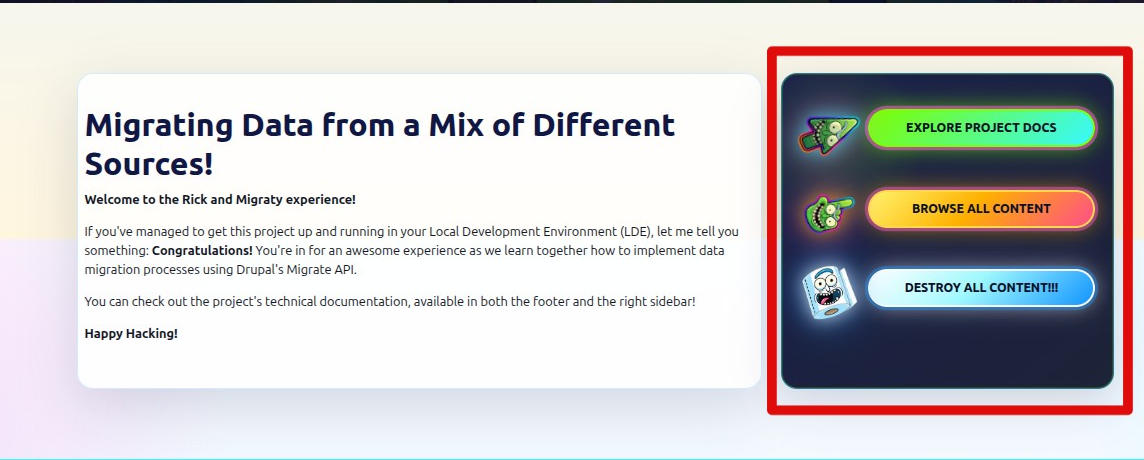 Menú de acciones: aprender, explorar y borrar cosas
¡Recuerda! Las credenciales de instalación son user: admin, password: admin. También puedes acceder a la documentación del proyecto en la URL local https://docs.rick-and-migraty.ddev.site. ¡Disfrútalo!
¿Te gusta lo que ves? Puedes apoyarme compartiendo este artículo, dando a conocer el repositorio (https://gitlab.com/davidjguru/rick-and-migraty) o añadiéndole una estrella en GitLab:
 ¡Apoya el proyecto con una estrella! ⭐
1. De dónde salió la idea (orígenes)
Durante una temporada estuve trabajando en procesos de migración en Drupal basados en la API Migrate. Algunas de aquellas experiencias profesionales terminaron convirtiéndose en la serie de artículos sobre migraciones en Drupal publicada aquí.
Por esas mismas fechas llegó a mi vida la serie de animación de Adult Swim Rick and Morty (2013–actualidad). Durante un tiempo fue una de mis series favoritas, a pesar de sus altibajos, gracias a su ritmo frenético, su absoluta falta de filtros, sus colores vibrantes y la excéntrica relación entre un científico loco (Rick Sanchez) y su nieto (Morty Smith).
Quería hacer algo con todo aquello: preparar una poción mágica con un poco de Drupal, mucho Rick and Morty y una dosis generosa de la API Migrate de Drupal. Llevaba tiempo dando vueltas a la idea de reunir información útil sobre la serie en una plataforma web que indexara su enorme cantidad de personajes, una cifra que parece crecer exponencialmente. Decidí probar… y así descubrí The Rick and Morty API, que me entusiasmó bastante.
Y así nació The Rick and Migraty Experience.
 La nueva experiencia Rick and Migraty: ¡Wubba Lubba Dub-Dub!
Algunos acontecimientos recientes me han dejado algo más de tiempo libre para retomar la idea justo donde la había dejado. Por suerte había conservado el trabajo anterior: investigación de experiencia de usuario, maquetas, esquemas de interfaz, diseños de entidades de Drupal y casos de uso para consultas. Montones de consultas, preparadas para recibir montones de respuestas JSON.
El tercer artículo de esta serie ya utilizaba una fuente con formato JSON, pero lo hacía mediante una transformación de una hoja de cálculo de Google y un analizador de un módulo contribuido que sabía interpretar aquella estructura especial. Esta vez quería centrarme en un escenario más propio del trabajo con API.
La API de Rick and Morty es un buen campo de pruebas para las migraciones en Drupal: es pública, lo bastante estable para un artículo, paginada, relacional y un poco disparatada en el buen sentido. Esa combinación vale más de lo que parece. Un ejemplo de migración no debería limitarse a importar tres filas planas y dar el trabajo por terminado; debería mostrar algunos de los problemas estructurales que encontramos en proyectos reales.
En este caso, el objetivo es diseñar el proceso de migración antes de escribir todo el código. Identificaremos los recursos de origen, propondremos un modelo de destino en Drupal, definiremos el orden de las operaciones y enumeraremos los plugins de proceso o transformaciones que probablemente necesitaremos.
2. Qué buscamos (objetivos)
La idea principal, el objetivo central, es construir una plataforma unificada para explorar y seguir tanto a los personajes que pueblan los episodios como a los propios episodios. Un lugar donde consultar perfiles de personajes como este:
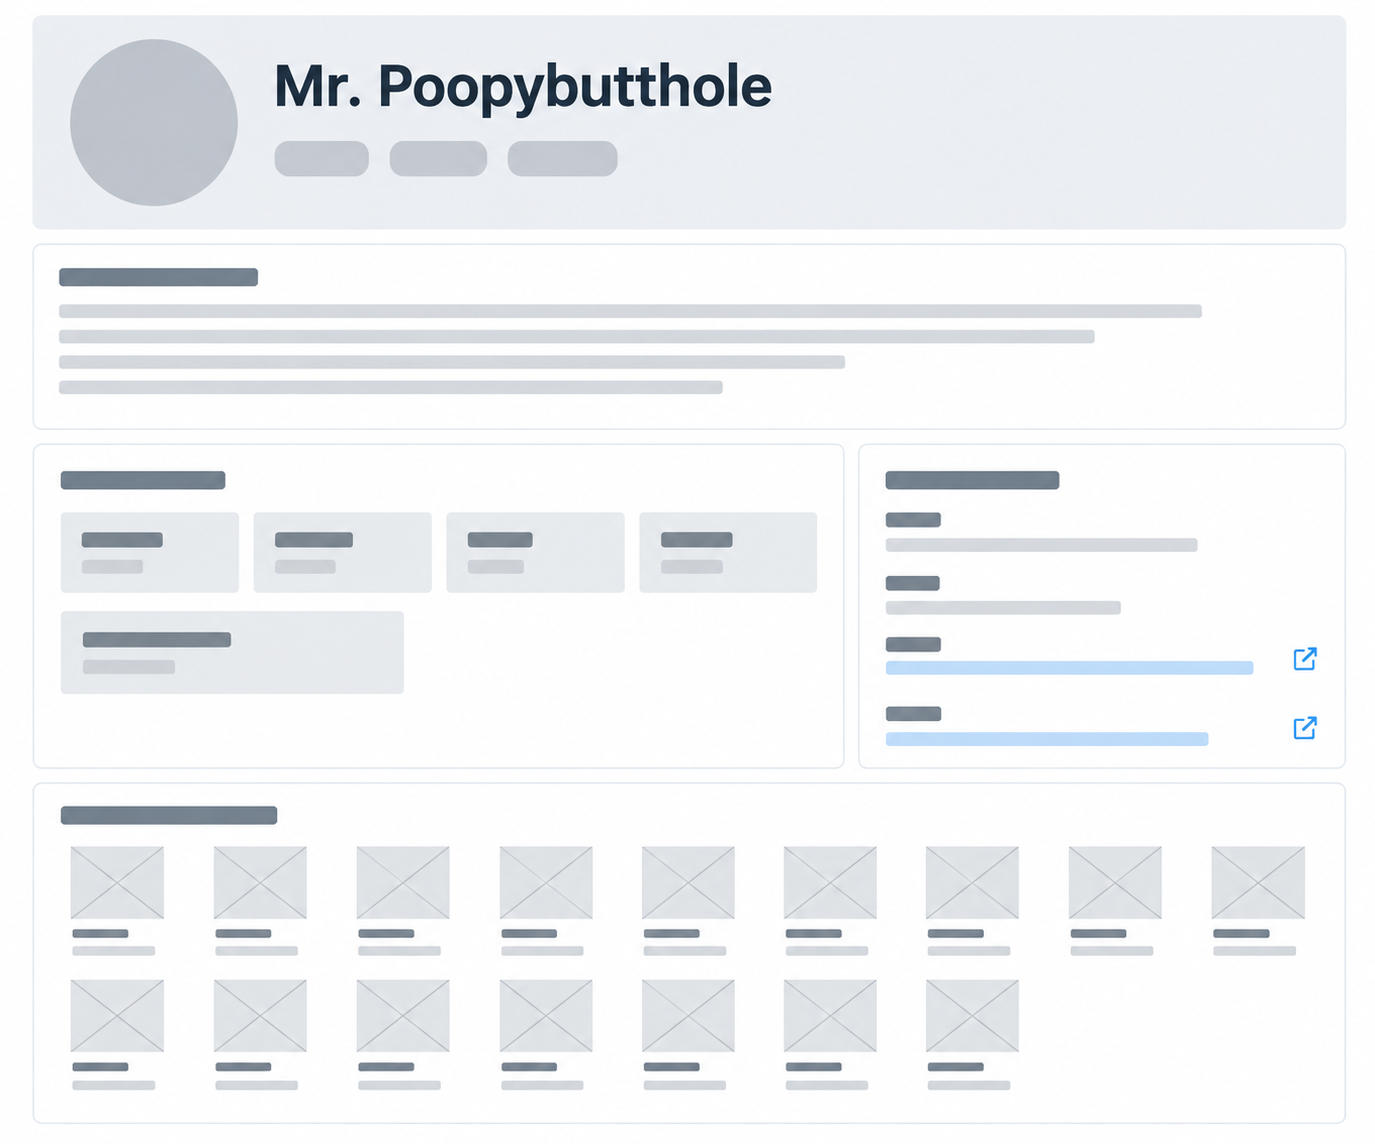 Esquema de baja fidelidad de un perfil de personaje
Un sitio que resulte útil para consultar información sobre los aproximadamente mil personajes existentes —las cifras varían según la fuente, pues muchos habitan en distintos lugares y no siempre hay consenso— y sobre los numerosos episodios y temporadas. Todo envuelto en una apariencia coherente, sencilla y atractiva. Se trata de convertir los bocetos originales en algo más interesante:
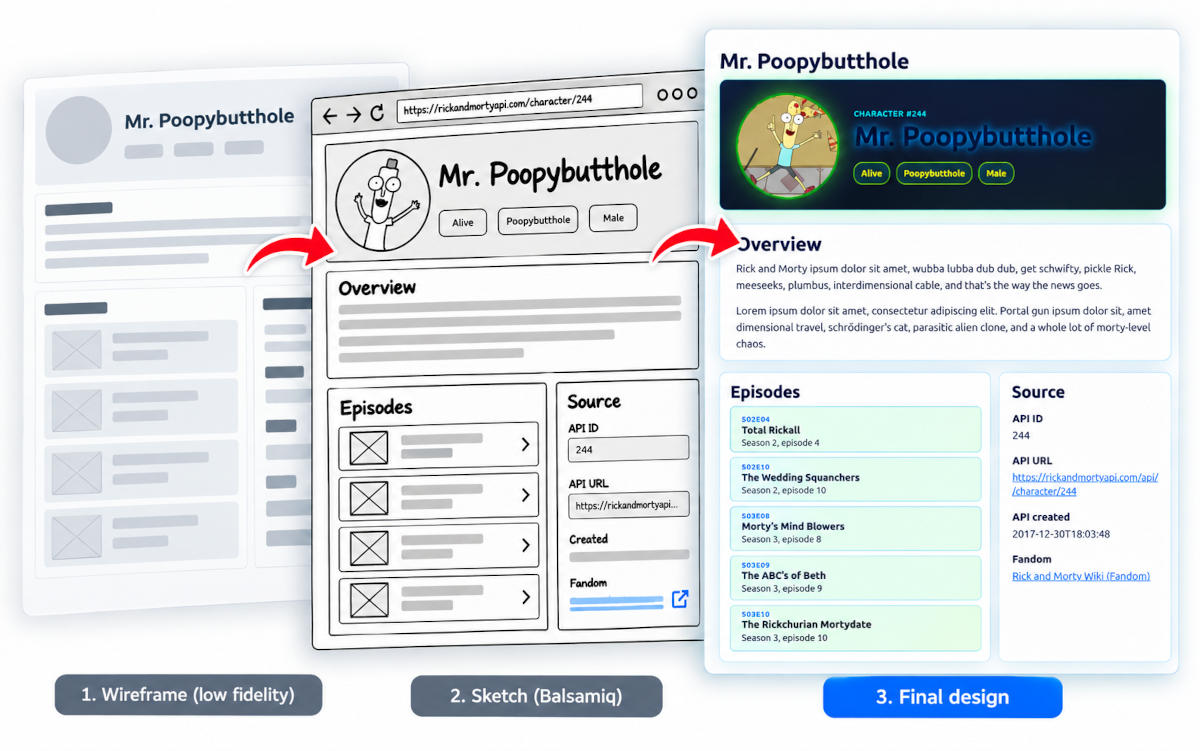 Evolución del perfil: del esquema a la maqueta y al diseño
En un plano más concreto necesitamos una navegación básica, directa e intuitiva; una pequeña herramienta de búsqueda fácil de usar, con la que localizar y filtrar información; y, junto a la plataforma de datos, un espacio centralizado para reunir la documentación y el conocimiento del proyecto.
Como ya existen plataformas de este tipo, necesitamos ir un paso más allá: reunir información que actualmente no se encuentra en un único lugar.
Para conseguirlo, diseñaremos un proceso de migración capaz de combinar datos de varias fuentes cuando sea necesario. Pero antes de escribir archivos YAML debemos comprender bien la naturaleza del problema —o, mejor dicho, del desafío tecnológico— que pretendemos resolver.
3. Analizar los datos (comprender)
Lo primero es pensar cómo modelar lo que buscamos: qué información queremos obtener, qué novedad queremos introducir para ofrecer algo distintivo, como comentábamos antes, y cómo vamos a hacerlo.
La primera pregunta es: ¿qué consideraríamos información valiosa? Aquí van algunas ideas:
- Disponer de una sinopsis de cada episodio que contextualice lo que sucede.
- Obtener una puntuación o valoración de cada episodio.
- Tener una lista de los personajes que aparecen en cada episodio.
- Contar con información de contexto sobre los personajes, ya sea biográfica o relacionada con su papel en la historia.
- Consultar la lista de episodios en los que aparece un personaje concreto.
Aquí comienza una breve fase de selección de fuentes de datos. Por razones obvias —forma parte de la motivación original del proyecto— queremos que la fuente principal sea The Rick and Morty API. Sin embargo, frente a los requisitos anteriores, esta API presenta algunas limitaciones:
- Los episodios no incluyen sinopsis ni descripción.
- Los episodios no incluyen puntuación ni valoración.
- Los personajes no incluyen descripción.
Esta API será la fuente canónica del dominio principal. Es decir, decidirá qué personajes, localizaciones y episodios existen en nuestro modelo de Drupal. Otras API podrán enriquecer los registros importados, pero no deberían alterar silenciosamente la identidad principal del conjunto de datos. Como puedes comprobar en la propia fuente (https://rickandmortyapi.com/documentation#get-a-single-episode), aún falta información para completar el modelo:
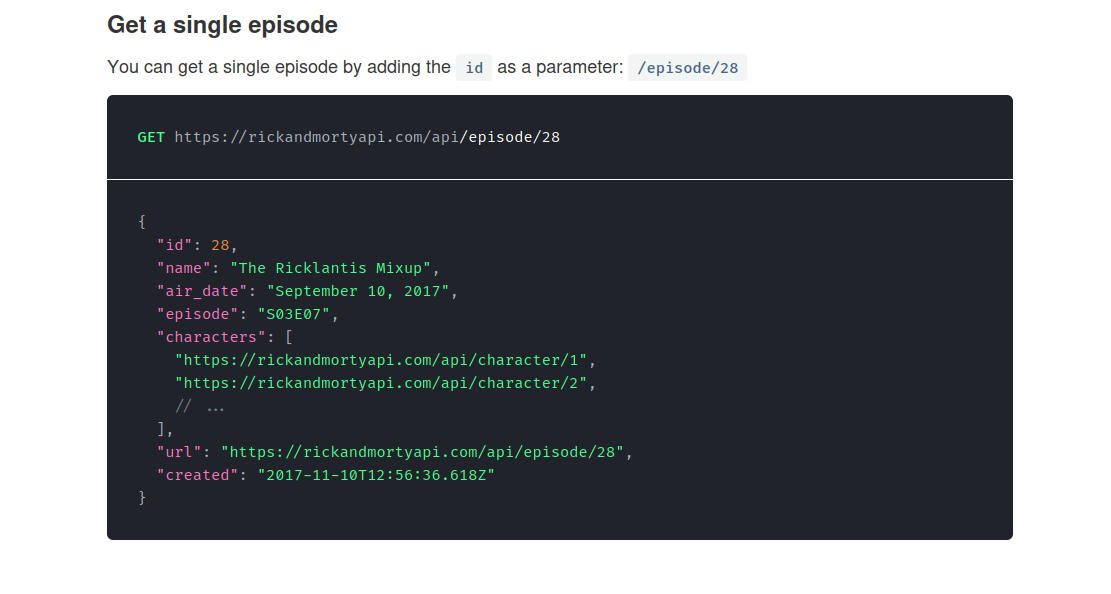 Ejemplo de datos obtenidos de un episodio
Por tanto, necesitamos fuentes adicionales que aporten lo que falta y enriquezcan los datos existentes: descripciones de episodios y personajes, y puntuaciones de episodios.
Para obtener las biografías y las sinopsis podemos utilizar la API de la wiki de Fandom, que ofrece esa información.
¿Y las puntuaciones de los episodios? Fandom puede ofrecer un campo llamado ratings, pero no se refiere a valoraciones o reseñas. En las páginas de episodios de la wiki de Rick and Morty en Fandom, ese campo parece representar cifras de audiencia, en millones de espectadores, y no una puntuación numérica.
Así que necesitamos otra fuente para obtener esas puntuaciones. Utilizaremos la API de TVmaze, una base de datos y plataforma comunitaria de seguimiento de series de televisión y series web.
Esto no consiste solo en «leer JSON y crear contenido en Drupal». Esa frase siempre se queda corta. Estamos modelando un pequeño dominio de contenido a partir de API remotas: personajes, lugares, episodios, puntuaciones, descripciones, referencias entre registros y reglas operativas para que las importaciones repetidas sean predecibles.
En resumen… En este punto ya trabajamos con tres API al modelar el contenido y la migración:
| API | Papel en la migración |
|---|---|
https://rickandmortyapi.com/api | Fuente canónica de personajes, localizaciones y episodios. Su punto de acceso raíz expone las tres colecciones principales: character, location y episode. |
https://rickandmorty.fandom.com/api.php | Interfaz de la wiki/MediaWiki para el contexto editorial que no forma parte de la identidad canónica de las entidades. Necesita un contrato explícito antes de permitirle escribir en campos de Drupal. |
https://www.tvmaze.com/api | API de metadatos televisivos utilizada como fuente secundaria para enriquecer las puntuaciones y conservar su trazabilidad mediante los puntos de acceso de series y episodios de TVmaze. |
Esta separación importa. Cuando varias API participan en el mismo modelo de destino, cada fuente necesita una responsabilidad clara. De lo contrario, la migración se convierte en una discusión silenciosa entre sistemas remotos y a Drupal le toca recoger el desastre.
Los tres recursos principales de la API de Rick and Morty deberían corresponderse de forma natural con entidades de contenido de Drupal:
- Personajes: son los registros más visibles. Contienen estado, especie, género, origen, última localización conocida, URL del avatar y referencias a episodios. También son lo primero que la mayoría querrá consultar.
- Localizaciones: proporcionan la estructura espacial del multiverso: planetas, cúmulos, dimensiones y otros lugares. No son meras etiquetas de los personajes, sino entidades con sus propios metadatos y relaciones inversas a través de sus residentes.
- Episodios: aportan la estructura narrativa. Conectan muchos personajes, tienen códigos de temporada y episodio y son el mejor lugar para integrar las puntuaciones de TVmaze, porque ambas API pueden ponerse de acuerdo sobre temporada y número de episodio.
En este artículo quiero tratarlos como datos estructurados reales del dominio, y no como JSON de ejemplo de usar y tirar. Por eso no nos limitaremos a importar personajes como nodos ignorando lo demás. De hecho, lo interesante es el grafo de relaciones:
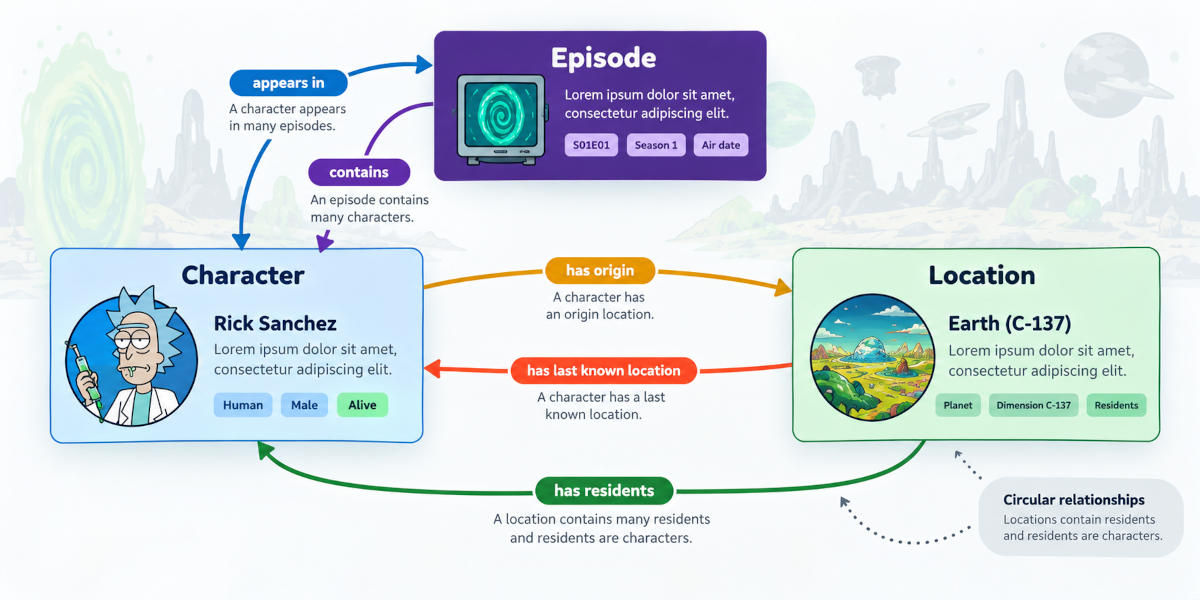 Relaciones entre conceptos y entidades del proceso de migración
Como muestra la imagen:
- Los personajes tienen un origen y una última localización conocida.
- Los personajes aparecen en episodios.
- Los episodios contienen muchos personajes.
- Las localizaciones contienen residentes.
- Los residentes son personajes.
Y sí: esto implica relaciones circulares.
4. Algunas restricciones iniciales (espera)
Esas relaciones circulares son la primera restricción arquitectónica. Nos indican que la migración no puede resolverse con una única importación heroica. Pongamos un poco de orden.
La primera restricción es el orden de migración. Las localizaciones y los episodios deben existir antes de que los personajes puedan referenciarlos. Los personajes deben existir antes de rellenar characters en los episodios y residents en las localizaciones. El orden no es un detalle técnico que dejamos para el final: forma parte del modelo de contenido.
La segunda restricción es la autoridad de las fuentes. Los registros de la API de Rick and Morty incluyen identificadores numéricos estables y URL de los recursos; esos valores serán nuestra capa de identidad externa mediante campos como api_id y api_url. TVmaze puede enriquecer episodios, pero no debería crear episodios adicionales en Drupal que no existan en la fuente canónica. Fandom puede aportar contexto editorial de la wiki, pero tampoco debe sobrescribir alegremente la fuente principal. Antes de introducir un valor en un campo de destino, debemos decidir si representa identidad de origen, enriquecimiento editorial, ayuda para la presentación o simples metadatos de diagnóstico.
La tercera restricción es la repetibilidad. Durante el desarrollo ejecutaremos muchas importaciones, reversiones y reinicios; limitaremos páginas, almacenaremos respuestas en caché y, a veces, utilizaremos fixtures. No es solo un ejercicio de modelado, sino también de operaciones: ¿podremos volver a ejecutar la migración mañana sin tener que adivinar el estado de la base de datos, las tablas de correspondencias o la API remota?
Bienvenidos a las migraciones. Los datos son un desastre, pero al menos vienen en JSON.
5. Contenedores de destino en Drupal (entidades)
Mi primera reacción es evitar los nodos. No porque tengan nada de malo, sino porque estos datos son importados, estructurados, externos y fuertemente relacionales. Parece más fiel a su naturaleza modelarlos como entidades de contenido personalizadas.
En el proyecto habrá un módulo personalizado dedicado a la API de entidades: rick_and_migraty_api.
Su función no es obtener datos remotos. Su función es proporcionar el modelo permanente de Drupal que rellenará la capa de migración y que después el sitio expondrá mediante rutas, Views, plantillas y navegación. Definirá tres entidades de contenido personalizadas:
- rick_and_migraty_character
- rick_and_migraty_location
- rick_and_migraty_episode
Las tres extienden la misma clase base abstracta:
Drupal\rick_and_migraty_api\Entity\RickAndMigratyEntityBase
Esta clase centraliza los campos necesarios para cualquier recurso importado: api_id, name, api_url, api_created, uid, created, changed y path. El fundamental es api_id: es obligatorio, tiene una restricción de unicidad y representa el identificador numérico estable de la API de Rick and Morty. En la práctica, es la identidad externa que utilizamos para actualizaciones, búsquedas de relaciones y depuración.
El campo name actúa también como etiqueta de la entidad mediante entity_keys, mientras que api_url y api_created permiten rastrear la entidad hasta el recurso remoto original. Los campos locales created y changed indican cuándo creó o actualizó Drupal su copia. Existe un campo uid porque son entidades de contenido reales y Drupal sigue necesitando un propietario para comprobar el acceso y gestionar los formularios de edición.
La entidad base conserva además los campos de enriquecimiento para una pasada posterior de Fandom: fandom_description, fandom_page_id, fandom_url y fandom_source. Es deliberado: la identidad canónica procede de la API de Rick and Morty, pero el contexto editorial puede llegar después desde la API de Wiki/Fandom, mediante una actualización independiente. El modelo hace visible esa diferencia, en lugar de fingir que todos los campos importados tienen la misma autoridad.
Por último, cada entidad incluye un campo base path. Así Pathauto tiene dónde guardar alias legibles, mientras las rutas canónicas internas permanecen estables.
Los tres tipos de entidad deben compartir también la misma estructura administrativa: rutas canónicas, de colección, creación, edición y borrado; un constructor de listados personalizado para los resúmenes administrativos; datos disponibles para Views; y un permiso común:
administer rick and migraty api entities
Un detalle pequeño pero importante: la visualización es pública, mientras las operaciones administrativas permanecen protegidas. Encaja con el objetivo del módulo: cualquiera puede recorrer el universo importado, pero la gestión de sus registros sigue sometida a los permisos de Drupal.
Localizaciones
Campos de rick_and_migraty_location:
| Campo | Tipo | Notas |
|---|---|---|
location_type | string | Asigna la propiedad type de la API sin utilizar el ambiguo nombre de campo type. |
dimension | string | Se almacena como texto porque las dimensiones no son un recurso normalizado independiente de la API. |
residents | referencia a entidad, múltiple | Referencia a rick_and_migraty_character. Se rellena cuando ya existen los personajes. |
Las localizaciones se importan pronto porque los personajes las referencian mediante origin y location.url. La relación inversa residents puede esperar a otra pasada. Así evitamos pedir a la migración que referencie personajes todavía inexistentes.
Episodios
Campos de rick_and_migraty_episode:
| Campo | Tipo | Notas |
|---|---|---|
air_date_raw | string | Conserva el valor legible original, como December 2, 2013. |
air_date | datetime, fecha | Fecha normalizada opcional para ordenar y filtrar cuando la conversión resulta fiable. |
episode_code | string | Guarda códigos como S01E01. |
season | integer | Se obtiene de episode_code. |
episode_number | integer | Se obtiene de episode_code. |
tvmaze_id | integer | Identificador del episodio en TVmaze para rastrear la puntuación. |
tvmaze_url | uri | URL canónica del episodio en TVmaze. |
rating_average | decimal | Puntuación media importada de TVmaze, con un decimal. |
rating_source | string | Etiqueta del proveedor de la puntuación. El valor esperado es TVmaze. |
characters | referencia a entidad, múltiple | Referencia a rick_and_migraty_character. Se rellena después de crear los personajes. |
Con los episodios empezamos a ir más allá de la API de Rick and Morty. Esta nos da la identidad, el título, el código y las URL de los personajes. TVmaze enriquece ese mismo episodio con su puntuación. Por eso la entidad almacena tanto los campos canónicos como los de trazabilidad de TVmaze.
Conservamos deliberadamente episode_code como texto de origen y lo descomponemos en season y episode_number. Estos enteros derivados resultan más útiles para filtrar, ordenar, emparejar episodios con TVmaze y construir la navegación.
Personajes
Campos de rick_and_migraty_character:
| Campo | Tipo | Notas |
|---|---|---|
status | list_string | Valores permitidos: Alive, Dead, unknown. |
species | string | Texto libre porque la API ofrece un conjunto abierto de valores. |
character_type | string | Asigna la propiedad type sin utilizar el ambiguo nombre de campo type. |
gender | list_string | Valores permitidos: Female, Male, Genderless, unknown. |
origin | referencia a entidad | Referencia a rick_and_migraty_location, resuelta desde origin.url cuando está disponible. |
last_location | referencia a entidad | Referencia a rick_and_migraty_location, resuelta desde location.url cuando está disponible. |
image_url | uri | Conserva la URL remota del avatar para mantener la trazabilidad. |
avatar | image | Imagen local descargada del avatar, guardada en public://rick-and-migraty/characters. |
episodes | referencia a entidad, múltiple | Referencia a rick_and_migraty_episode. |
Los personajes son las entidades más conectadas: apuntan a localizaciones y episodios y aparecen en sus listas inversas. Por eso su migración no debe ejecutarse primero. Necesita que las localizaciones y los episodios existan para resolver con seguridad origin, last_location y episodes.
La URL remota image_url y el campo local avatar están separados intencionadamente. La primera conserva el dato de la API; el segundo representa un archivo gestionado por Drupal que podemos mostrar de manera uniforme en las páginas de personajes.
El módulo mantiene así un grafo que refleja la API de origen, sin obligarnos a resolver todo en una única pasada:
rick_and_migraty_character.originapunta arick_and_migraty_location.rick_and_migraty_character.last_locationapunta arick_and_migraty_location.rick_and_migraty_character.episodesapunta arick_and_migraty_episode.rick_and_migraty_episode.charactersvuelve a apuntar arick_and_migraty_character.rick_and_migraty_location.residentsvuelve a apuntar arick_and_migraty_character.
Al ser entidades de contenido personalizadas, participan de forma natural en Views, rutas de entidad, plantillas y permisos, sin hacerse pasar por nodos editoriales normales. Puedes ver las entidades implementadas en el repositorio.
El proyecto define además patrones legibles de Pathauto:
| Tipo de entidad | Patrón del alias |
|---|---|
| Personaje | /rick-and-migraty/characters/[rick_and_migraty_character:name] |
| Localización | /rick-and-migraty/locations/[rick_and_migraty_location:name] |
| Episodio | /rick-and-migraty/episodes/[rick_and_migraty_episode:name] |
Estos alias son deliberadamente plurales y fáciles de leer. Por debajo, las rutas canónicas siguen siendo rutas estables de Drupal, como /rick-and-migraty/character/{rick_and_migraty_character}. Esta separación mantiene predecible la implementación y agradables las URL públicas.
6. Diseñar la migración (cocinar)
Una vez resuelto —o casi— el modelo de destino, el siguiente paso no es escribir archivos YAML a toda velocidad. Ahora toca cocinar el diseño: comprender cómo se organizan los datos de origen, decidir el orden de importación, determinar qué problemas podemos resolver con YAML y cuáles requieren plugins personalizados y, solo entonces, conectar origen, proceso y destino.
También debemos asumir que aparecerán dificultades y retos nuevos por el camino. Habrá que iterar, experimentar y encontrar soluciones mediante ensayo y error. Paciencia.
Para empezar a cocinar, recordemos que la API de Rick and Morty es una API REST que devuelve JSON. No es JSON:API en el sentido estricto del módulo del núcleo de Drupal. Sin embargo, desde la perspectiva de una migración, la idea fundamental es la misma: recibir registros estructurados de una fuente remota y transformarlos en entidades de Drupal.
La API utiliza peticiones GET sobre HTTPS y devuelve respuestas JSON. Los puntos de acceso de los listados están paginados e incluyen un objeto info con los metadatos de paginación:
{
  "info": {
    "count": 826,
    "pages": 42,
    "next": "https://rickandmortyapi.com/api/character/?page=2",
    "prev": null
  },
  "results": []
}
La fuente proporciona tres colecciones principales:
| Recurso | Punto de acceso | Cantidad aproximada |
|---|---|---|
| Personajes | /api/character | 826 |
| Localizaciones | /api/location | 126 |
| Episodios | /api/episode | 51 |
Las cifras exactas importan menos que la estructura de los datos de origen:
- Los resultados de los listados están en
results. - La paginación está en
info.next. - Las relaciones se representan mediante URL.
- Cada objeto tiene un identificador numérico estable.
- Desde nuestro punto de vista, la fuente es de solo lectura.
Un registro de personaje permite ver el principal problema de la migración:
{
  "id": 1,
  "name": "Rick Sanchez",
  "status": "Alive",
  "species": "Human",
  "type": "",
  "gender": "Male",
  "origin": {
    "name": "Earth (C-137)",
    "url": "https://rickandmortyapi.com/api/location/1"
  },
  "location": {
    "name": "Citadel of Ricks",
    "url": "https://rickandmortyapi.com/api/location/3"
  },
  "image": "https://rickandmortyapi.com/api/character/avatar/1.jpeg",
  "episode": [
    "https://rickandmortyapi.com/api/episode/1",
    "https://rickandmortyapi.com/api/episode/2"
  ],
  "url": "https://rickandmortyapi.com/api/character/1",
  "created": "2017-11-04T18:48:46.250Z"
}
El contenido es fácil de leer, pero no es plano. Los personajes apuntan a localizaciones y episodios mediante URL. Los episodios vuelven a apuntar a personajes. Las localizaciones apuntan a residentes, que también son personajes. En otras palabras, la fuente es lo bastante pequeña para explicarla en un artículo, pero lo bastante relacional para obligarnos a tomar decisiones reales de migración.
La primera decisión es el orden de importación. Si intentamos resolver todo el grafo en una única importación heroica, nos estamos ofreciendo voluntarios para sufrir.
El proceso que implementaremos estará dividido en fases:
- Importar las localizaciones.
- Importar los episodios, ya enriquecidos con las puntuaciones de TVmaze cuando estén disponibles.
- Descargar los archivos de los avatares.
- Importar los personajes, resolviendo localizaciones, episodios y archivos de avatar.
- Actualizar los episodios para resolver su campo
characters. - Actualizar las localizaciones para resolver su campo
residents.
Esta secuencia es la respuesta práctica al grafo circular. Algunos campos de relación ya figuran en el YAML de la primera migración, pero migration_lookup utiliza no_stub: true, de modo que las referencias no resueltas no crean entidades provisionales. Las referencias inversas pendientes se completan después con --update, cuando ya existen las entidades locales de los personajes.
Ahora que la secuencia está clara, por fin toca implementar los pasos que acabamos de describir. Sigamos.
Primero, las localizaciones
En esta migración, una localización es un dato fundamental sobre un personaje: nos dice de dónde procede y dónde estaba establecido, al menos al principio, porque los personajes importantes suelen moverse entre dimensiones, planetas y demás.
Las localizaciones son el primer contenedor estable, ya que los personajes las necesitan para origin y last_location.
- Punto de acceso:
/api/location.
Cargaremos:
api_idnamelocation_typedimensionapi_urlapi_created
Esta es la definición completa de la migración de localizaciones:
| |
Source: Archivo fuente en GitLab
El primer bloque es la definición del origen. En lugar de enumerar URL concretas, la migración pide al plugin personalizado rick_and_morty_api el recurso location. Ese pequeño ajuste, resource: location, basta para que construya el primer punto de acceso, siga la paginación, almacene las respuestas en caché y exponga cada localización de results como una fila de migración.
Las asignaciones directas de campos son deliberadamente aburridas, y eso es bueno. api_id guarda el identificador numérico externo; name, la etiqueta visible; location_type recibe el valor type de la API; y dimension conserva el espacio ficticio al que pertenece la localización. Por su parte, api_url y api_created permiten rastrear el registro hasta la respuesta original.
Hay una transformación que merece atención: api_created utiliza format_date. La fuente proporciona una marca temporal como 2017-11-10T12:42:04.162Z; Drupal la guarda en UTC con el formato más limpio Y-m-d\TH:i:s. No es una transformación espectacular, pero estas pequeñas normalizaciones facilitan consultar los datos después.
La asignación de residents resulta más interesante porque es un campo de relación. Las filas contienen un array de URL de personajes, no identificadores locales de Drupal. Por eso el proceso utiliza primero rick_and_migraty_url_id para extraer los identificadores numéricos y después migration_lookup contra rick_and_migraty_character.
En la primera pasada, esas búsquedas todavía no pueden resolverse porque no existen los personajes. No es un fallo del YAML, sino parte del diseño. no_stub: true indica a Drupal que no cree personajes provisionales solo para satisfacer la relación antes de tiempo. Más adelante, cuando la migración de personajes haya creado las entidades reales, se ejecutará esta misma migración con --update para rellenar residents.
Por último, el destino es explícito: entity:rick_and_migraty_location. No creamos nodos, términos de taxonomía ni registros genéricos. Rellenamos la entidad personalizada definida por rick_and_migraty_api, con la validación activada para que las filas incorrectas fallen de forma visible durante la importación y no creen silenciosamente contenido incompleto.
Después, los episodios
Los episodios son el segundo contenedor estable del grafo. Los personajes pueden aparecer en muchos episodios y las páginas de episodios necesitarán enumerarlos, pero los propios episodios pueden crearse antes de que existan los personajes. Por eso podemos importarlos con seguridad antes de su migración.
- Punto de acceso:
/api/episode.
La migración guarda tanto los datos originales del episodio como los valores normalizados que necesitaremos después.
Cargaremos:
api_idnameair_date_rawair_dateepisode_codeseasonepisode_numbertvmaze_idtvmaze_urlrating_averagerating_sourceapi_urlapi_created
Esta es la definición completa:
| |
Source: Archivo fuente en GitLab
Lo primero que observamos es que el plugin de origen sigue siendo rick_and_morty_api, pero resource cambia a episode. Así conservamos la paginación, la caché y las pausas entre peticiones en un único plugin reutilizable, mientras el YAML describe la entidad concreta que queremos rellenar.
La sección de proceso realiza tres tipos de trabajo. Algunos campos son copias directas de la fila de origen: api_id, name, episode_code y api_url. Otros se interpretan o normalizan: air_date convierte una fecha legible como December 2, 2013 a Y-m-d; season y episode_number utilizan el plugin de proceso personalizado rick_and_migraty_episode_part para descomponer valores como S01E01.
Los campos de TVmaze ya están presentes en la fila de origen cuando se ejecuta el proceso. Con resource: episode, el plugin puede cargar los episodios de la serie 216 de TVmaze, construir una tabla de consulta por temporada y número de episodio y añadir tvmaze_id, tvmaze_url, rating_average y rating_source a la fila. Es un límite importante: TVmaze enriquece las filas canónicas, pero no crea episodios.
Por último, characters aparece en el YAML aunque los personajes aún no existan durante la primera pasada. La pareja rick_and_migraty_url_id + migration_lookup repite el mismo patrón de relaciones utilizado en las localizaciones. Con no_stub: true, las referencias no resueltas no se convierten en entidades provisionales. Después de crear los personajes, el proyecto vuelve a ejecutar esta migración con --update.
Los avatares antes que los personajes
Los avatares se gestionan deliberadamente en una migración de archivos separada. Puede parecer un paso adicional, pero mantiene una operación frágil fuera de la importación principal de personajes. Descargar archivos remotos es distinto de asignar campos JSON: puede ser lento, fallar o verse limitado por el servidor.
La migración lee las filas de /api/character, toma la URL remota image y descarga el archivo en el sistema público de archivos de Drupal, bajo:
public://rick-and-migraty/characters/
Esta es la migración de los archivos de avatar:
| |
Source: Archivo fuente en GitLab
El origen vuelve a ser rick_and_morty_api, ahora con resource: character, porque la URL del avatar está en los datos del personaje. El bloque constants define dos valores que no proceden de la API: el directorio de destino y la extensión del archivo. Mantenerlos en constants facilita leer la sección de proceso.
Los campos filename y destination_uri se construyen con concat. Un personaje con identificador de origen 1 se convierte en 1.jpeg, y la URI final será public://rick-and-migraty/characters/1.jpeg. Ese nombre determinista ayuda a repetir la operación: la misma fila apunta siempre a la misma ruta local.
La descarga se realiza en el proceso del campo uri. El plugin download recibe dos valores: la URL remota y la URI de destino calculada. Con file_exists: replace, las importaciones repetidas pueden actualizar el archivo en vez de fallar porque un intento anterior ya lo creó.
El destino es entity:file, no una de nuestras entidades de contenido de Rick and Migraty. Esta migración solo crea entidades de archivo reutilizables. Después, la migración de personajes resolverá avatar/target_id mediante migration_lookup.
Los personajes después de las localizaciones, los episodios y los avatares
Los personajes son el centro de la experiencia de navegación, pero llegan después de las localizaciones, los episodios y los archivos de avatar. El orden no es arbitrario: necesitan localizaciones para origin y last_location, episodios para episodes y una entidad de archivo para avatar.
El punto de acceso es /api/character, y la migración rellena:
- Campos básicos como
api_id,name,status,species,character_typeygender. - Referencias a localizaciones mediante
originylast_location. - La URL remota
image_url. - El campo de imagen local
avatar. - Referencias a episodios mediante
episodes. - Campos de trazabilidad de la API y de propiedad de la entidad.
Esta es la migración implementada:
| |
Source: Archivo fuente en GitLab
El primer grupo de asignaciones es directo: api_id, name, status, species, character_type y gender se copian de los datos del personaje. Observa que el campo type de la API pasa a llamarse character_type en Drupal. Así evitamos confundirlo con el concepto habitual de «tipo» en Drupal y conservamos su valor original.
Las asignaciones de origin y last_location muestran el proceso de resolución de relaciones en su forma más útil. La API anida las URL bajo origin/url y location/url. El plugin rick_and_migraty_url_id extrae su identificador numérico y migration_lookup lo resuelve mediante la tabla de correspondencias de rick_and_migraty_location.
El avatar es algo distinto porque apunta a la migración de archivos, no a una entidad de contenido personalizada. avatar/target_id busca la entidad creada por rick_and_migraty_character_avatar utilizando el mismo identificador de origen del personaje. avatar/alt se obtiene de su nombre para proporcionar un texto alternativo útil.
El campo episodes utiliza el mismo patrón de extracción del identificador de una URL, pero sobre un array de URL de episodios. Como estos ya se importaron, las búsquedas pueden resolverse en la primera pasada de personajes.
El bloque final de dependencias documenta explícitamente el orden de ejecución: los personajes requieren archivos de avatar, localizaciones y episodios. Así Migrate dispone de información suficiente para entender por qué esta migración ocupa una posición posterior en el proceso básico.
Relaciones inversas después del grafo básico
Llegados a este punto, ya existen las relaciones de ida:
- Los personajes apuntan a su origen y a su última localización conocida.
- Apuntan a los episodios en los que aparecen.
- Apuntan a su archivo local de avatar.
Pero quedan dos relaciones inversas útiles por completar:
rick_and_migraty_episode.charactersrick_and_migraty_location.residents
Estas asignaciones ya existen en los YAML de episodios y localizaciones. La razón por la que no se resuelven por completo en la primera pasada es temporal: ambos se importan antes que los personajes. Sus filas ya contienen las URL de los personajes, pero las entidades locales todavía no existen.
Por eso ambas asignaciones utilizan la misma pareja de plugins con precaución:
-
  plugin: rick_and_migraty_url_id
-
  plugin: migration_lookup
  migration: rick_and_migraty_character
  no_stub: true
El plugin personalizado extrae los identificadores de personajes de las URL. migration_lookup consulta la tabla de correspondencias de Migrate para averiguar dónde terminaron esos personajes en Drupal. no_stub: true evita crear personajes provisionales incompletos cuando la búsqueda todavía no puede resolverse.
Una vez ejecutada la migración de personajes, se realizan pasadas de actualización:
ddev drush migrate:import rick_and_migraty_episode --update
ddev drush migrate:import rick_and_migraty_location --update
Es entonces cuando el grafo se vuelve bidireccional en Drupal, sin obligar a la primera importación a conocerlo todo a la vez. El mismo YAML sirve para la importación inicial y para completar las relaciones más adelante.
Estrategia de origen: no fijar la paginación a mano
Todas las definiciones anteriores comparten un supuesto discreto: ninguna quiere saber cuántas páginas tiene hoy la API remota. El YAML debe indicar qué recurso necesita, no mantener manualmente una lista de URL.
En Drupal, esa responsabilidad vive en un módulo de migración dedicado:
rick_and_migraty_migrate
Este módulo contiene el plugin de origen, los YAML, los plugins de proceso y las utilidades Drush del proyecto. La pregunta interesante es cuánto comportamiento de la API debe vivir en PHP reutilizable y cuánto debería repetirse en cada archivo de migración.
La API de Rick and Morty devuelve respuestas paginadas. Cada respuesta incluye info.next y un array results. Un origen genérico url con un analizador JSON puede leer un punto de acceso, pero seguimos necesitando recorrer cómodamente todas las páginas y exponer cada elemento de results como una fila.
Una posibilidad sería utilizar un origen URL genérico y enumerar explícitamente todas las páginas:
source:
  plugin: url
  data_fetcher_plugin: http
  data_parser_plugin: json
  urls:
    - 'https://rickandmortyapi.com/api/location?page=1'
    - 'https://rickandmortyapi.com/api/location?page=2'
    - 'https://rickandmortyapi.com/api/location?page=3'
  item_selector: results
Puede funcionar en una pequeña demostración, pero es frágil. Si cambia el número de páginas, debemos cambiar la definición. Si necesitamos migraciones de personajes, localizaciones y episodios, el mismo problema de paginación se extiende a varios YAML. Y si queremos controles locales, como caché o limitar una prueba a una página, habrá que repetir la lógica o envolverla en otra capa.
El proyecto adopta una opción mejor: un plugin de origen personalizado de Migrate, llamado rick_and_morty_api.
Cada migración elige el recurso con un pequeño ajuste:
source:
  plugin: rick_and_morty_api
  resource: location
El mismo plugin puede leer character, location o episode. Internamente construye la primera URL a partir del recurso, obtiene la respuesta, reúne las filas de results, sigue info.next y se detiene cuando no hay más páginas o cuando un límite local dice «suficiente por esta vez».
En la práctica, el plugin realiza cuatro tareas por los archivos YAML:
- Comienza por el primer punto de acceso.
- Lee
info.next. - Entrega cada elemento de
results. - Se detiene cuando
nextesnull.
Así las definiciones son más pequeñas y la paginación se convierte en código reutilizable. El YAML se centra en el contrato de la migración: recurso de origen, asignaciones de proceso, plugin de destino y dependencias.
El plugin incluye también controles para el desarrollo local. Importan porque las migraciones no son solo código: son operaciones que ejecutaremos una y otra vez mientras desarrollamos, depuramos y revertimos:
| Ajuste | Valor predeterminado | Para qué sirve |
|---|---|---|
base_url | https://rickandmortyapi.com/api | Permite apuntar a otra URL base compatible. |
skip_count | true | Evita recorrer toda la API solo para calcular los totales. |
cache | true | Reutiliza respuestas remotas en ejecuciones locales repetidas. |
cache_ttl | 86400 | Conserva las respuestas durante un día. |
request_delay_ms | 0 | Introduce una pausa entre peticiones sin caché cuando aparecen limitaciones. |
max_pages | sin definir | Limita las pruebas básicas a unas pocas páginas. |
fixture_base_path | sin definir | Utiliza archivos JSON locales deterministas en lugar de HTTP remoto. |
enrich_tvmaze_ratings | true | Integra las puntuaciones de TVmaze en las filas de episodios. |
tvmaze_base_url | https://api.tvmaze.com | Permite redirigir las llamadas a TVmaze en entornos controlados. |
tvmaze_show_id | 216 | Identificador fijo de Rick and Morty en TVmaze. |
Para las pruebas locales, podemos sobrescribir varios ajustes mediante variables de entorno, sin editar los YAML versionados:
ddev exec env RICK_AND_MIGRATY_API_MAX_PAGES=1 \
  RICK_AND_MIGRATY_API_REQUEST_DELAY_MS=250 \
  drush migrate:import rick_and_migraty_location
La implementación permite sobrescribir la URL base de Rick and Morty, la pausa entre peticiones, el límite de páginas, la ruta de los archivos de prueba, la URL base de TVmaze y su identificador de serie. Las migraciones versionadas permanecen estables, mientras las ejecuciones locales pueden ser más rápidas, más lentas, basarse en archivos locales o apuntar a otro servidor.
Aquí es también donde encaja arquitectónicamente el enriquecimiento de TVmaze. El YAML de episodios asigna tvmaze_id, tvmaze_url, rating_average y rating_source, pero no necesita saber cómo se obtuvieron. El plugin enriquece las filas antes de entregarlas al proceso. Cuando se ejecuta el YAML, los datos de TVmaze se comportan como columnas adicionales de la fila canónica.
Es una decisión arquitectónica pequeña pero importante. Permite tratar con consideración a la API pública sin perder rapidez al probar cambios. También mantiene legibles las definiciones: localizaciones, episodios, avatares y personajes comparten el plugin, pero cada migración declara únicamente el recurso y los campos que le interesan.
Llegados aquí, el diseño ya no consiste simplemente en «importar JSON a Drupal». Es una secuencia:
- Importar los contenedores canónicos.
- Derivar campos normalizados.
- Resolver referencias a partir de URL.
- Descargar avatares con una migración de archivos ejecutable por lotes.
- Enriquecer determinados registros desde fuentes secundarias.
- Permitir almacenar en caché, limitar y repetir las peticiones remotas.
- Completar las relaciones inversas mediante actualizaciones cuando ya exista el grafo.
Esta es la receta. Ahora podemos examinar los plugins que convierten esas decisiones en código reutilizable. Las definiciones implementadas están en el repositorio.
7. Definir plugins de migración (soluciones)
La sección anterior describe el orden de la migración. Esta trata sobre las pequeñas piezas de código personalizado que hacen legible ese orden.
Llega un momento en que una migración deja de ser solo YAML. No es un fallo de la API Migrate, sino una de sus virtudes. YAML es excelente para declarar cómo una fila se convierte en una entidad, pero las reglas específicas del proyecto necesitan nombres, límites y pruebas. En Rick and Migraty, los plugins son precisamente eso: soluciones con nombre para problemas que se repiten.
Aquí la implementación se vuelve más honesta. Si forzamos todas las reglas dentro del YAML, las definiciones se vuelven ruidosas y frágiles. Si trasladamos cada pequeña asignación a PHP, el YAML deja de documentar la importación. La pregunta útil no es «¿YAML o PHP?», sino «¿qué responsabilidad corresponde a cada lugar?».
El proyecto utiliza cuatro plugins personalizados:
| Plugin | Tipo | Qué problema evita |
|---|---|---|
rick_and_morty_api | Origen | Fijar a mano las URL paginadas, repetir la lógica de caché y obligar a cada migración a conocer info.next. |
rick_and_migraty_fandom | Origen | Tratar Fandom como un segundo conjunto canónico en vez de como una capa de enriquecimiento sobre entidades existentes. |
rick_and_migraty_url_id | Proceso | Repetir el análisis de URL cada vez que una relación de la API debe convertirse en referencia a entidad. |
rick_and_migraty_episode_part | Proceso | Mantener S03E07 eternamente como cadena cuando necesitamos números de temporada y episodio. |
Ninguno es especialmente grande. Esa es parte de la idea: resolver problemas pequeños y repetidos, y mantener las definiciones centradas en el modelo de contenido, no en los detalles de bajo nivel.
Aquí conviene hacer autocrítica: los plugins personalizados no deberían ser la respuesta por defecto. El núcleo y los módulos contribuidos ya ofrecen muchas herramientas. Utilizamos plugins estándar como format_date, concat, download, default_value y migration_lookup; además, migrate_plus aporta el origen genérico url, analizadores JSON y plugins de proceso como preg_match.
¿Por qué no usar migrate_plus:url para todo? En una prueba de concepto pequeña podríamos hacerlo. Pero la fuente canónica de Rick and Morty no es solo «un archivo JSON en una URL». Tiene paginación mediante info.next, caché, pausas entre peticiones, soporte para archivos locales, límites de páginas para pruebas y enriquecimiento de episodios con TVmaze. Si todo ese comportamiento vive en YAML, cada migración acaba describiendo políticas operativas además de asignaciones de datos.
La fuente de Fandom también tiene motivos para ser personalizada. Parte de entidades existentes, resuelve una página mediante identificadores, alias o coincidencias exactas, omite resultados ambiguos, analiza HTML de MediaWiki y genera filas de actualización para entidades de destino existentes. Un plugin URL genérico puede obtener JSON, pero no sabe que Fandom es una capa de enriquecimiento sobre registros que ya existen en Drupal.
El compromiso es este: los plugins de origen son personalizados porque definen contratos con las fuentes, no porque nos apeteciera escribir PHP. Los pequeños plugins de proceso merecen un examen más crítico. rick_and_migraty_url_id sigue teniendo sentido porque maneja tanto URL individuales como arrays en un paso legible. Sin embargo, rick_and_migraty_episode_part podría sustituirse por preg_match de migrate_plus:
season:
  plugin: preg_match
  source: episode
  pattern: '/^S(\d+)E(\d+)$/'
  group_index: 1

episode_number:
  plugin: preg_match
  source: episode
  pattern: '/^S(\d+)E(\d+)$/'
  group_index: 2
Esa sustitución reduciría el código propio. Mantener el plugin se justificaría por la legibilidad y la intención de los tipos, no por una necesidad técnica. Precisamente quiero hacer visible esa diferencia: el código personalizado es aceptable cuando da nombre a un contrato real del proyecto; resulta sospechoso cuando solo oculta una transformación que ya ofrecen el núcleo o los módulos contribuidos.
El plugin de la fuente canónica
rick_and_morty_api se ocupa de la fuente principal de datos. Recibe un nombre de recurso, comienza en su punto de acceso, sigue la paginación mediante info.next y entrega cada elemento de results como una fila de Migrate.
Por tanto, el YAML puede decir:
source:
  plugin: rick_and_morty_api
  resource: episode
  skip_count: true
  cache: true
  cache_ttl: 86400
  request_delay_ms: 0
Es mucho más fácil de mantener que enumerar todas las páginas a mano. Y, sobre todo, ofrece un único lugar para gestionar las cuestiones operativas:
| Ajuste | Para qué sirve |
|---|---|
skip_count | Evita recorrer toda la API pública solo porque migrate:status quiere calcular totales. |
cache y cache_ttl | Hacen las importaciones locales repetidas más rápidas y menos exigentes con la fuente. |
request_delay_ms | Permite ralentizar las ejecuciones cuando la API empieza a limitar peticiones. |
max_pages | Permite realizar pruebas básicas sin importar todos los datos. |
fixture_base_path | Permite leer instantáneas JSON locales en vez de hacer peticiones HTTP. |
tvmaze_base_url | Permite redirigir las llamadas a TVmaze en entornos controlados. |
tvmaze_show_id | Vincula el enriquecimiento a una serie de TVmaze fija y explícita. |
Es uno de esos detalles modestos que cambian el día a día. Ejecutar una migración diez veces durante el desarrollo no debería implicar pedir diez veces las mismas páginas a una API pública.
El plugin completo está en RickAndMortyApi.php. Para este artículo importa menos cada línea de la clase que el contrato que ofrece al YAML: elige un recurso, recibe filas y mantén centralizada la relación con el sistema remoto.
El problema del lenguaje de las URL
La API de Rick and Morty expresa las relaciones como URL:
https://rickandmortyapi.com/api/location/20
https://rickandmortyapi.com/api/episode/1
https://rickandmortyapi.com/api/character/42
Las referencias a entidades de Drupal no necesitan esas URL. Necesitan identificadores locales de entidades de destino. El puente es el plugin de proceso rick_and_migraty_url_id.
Esta es su implementación:
| |
Source: Archivo fuente en GitLab
Hace una sola cosa: extraer el segmento numérico final de una URL de la API de Rick and Morty. Si recibe una URL, devuelve un entero. Si recibe un array, aplica la misma operación a cada elemento y filtra los valores vacíos o mal formados.
Para una relación individual, el proceso es fácil de leer:
origin:
  -
    plugin: rick_and_migraty_url_id
    source: origin/url
  -
    plugin: migration_lookup
    migration: rick_and_migraty_location
    no_stub: true
El primer plugin extrae el identificador de origen. El segundo pregunta a la tabla de correspondencias de la API Migrate qué entidad local se creó a partir de ese identificador. El mismo patrón funciona con arrays como episode.characters, location.residents y character.episode.
Es un buen ejemplo de un plugin de proceso que hace lo justo. No sabe de personajes, localizaciones, episodios ni campos. Solo traduce el lenguaje de relaciones de la API a identificadores que Drupal puede buscar.
Convertir los códigos de episodio en estructura
Los códigos de episodio requieren otra transformación pequeña pero importante. La API proporciona valores como:
S03E07
Son útiles para las personas, pero insuficientes para ordenar, filtrar o cruzar los datos con TVmaze. El modelo guarda tanto el código original como sus partes estructuradas:
season:
  plugin: rick_and_migraty_episode_part
  source: episode
  part: season
episode_number:
  plugin: rick_and_migraty_episode_part
  source: episode
  part: episode
El plugin implementado es deliberadamente estricto:
| |
Source: Archivo fuente en GitLab
Exige part: season o part: episode y acepta valores con la forma S03E07. Si el valor no encaja, devuelve NULL en vez de inventarse un número. Importa porque los valores incorrectos de origen no deberían convertirse silenciosamente en una estructura falsa.
El resultado es sencillo:
episode_code = S03E07
season = 3
episode_number = 7
Este tipo de transformación facilita el resto del proyecto. Views puede agrupar por temporada, las páginas pueden ordenar los episodios de forma natural y las puntuaciones de TVmaze pueden emparejarse por temporada y número, en lugar de por título.
Puedes consultar los plugins personalizados de origen y proceso en el repositorio.
8. Más información de las fuentes (enriquecimiento)
El proyecto utiliza tres fuentes externas, pero no todas tienen la misma autoridad.
La API de Rick and Morty es la fuente canónica del conjunto básico: personajes, localizaciones, episodios y su grafo de relaciones. TVmaze y Fandom añaden información que la fuente principal no proporciona, pero no deben redefinir silenciosamente qué considera el proyecto un personaje, una localización o un episodio.
Esa distinción mantiene la migración bajo control. Nos ofrece una regla que podemos repetir durante toda la implementación: las fuentes secundarias enriquecen registros existentes; no crean el conjunto canónico.
TVmaze enriquece las filas de episodios
La API de Rick and Morty proporciona la identidad del episodio, su código, la fecha de emisión y la lista de personajes que aparecen. No ofrece puntuaciones. TVmaze cubre esa carencia.
La decisión importante es evitar las búsquedas aproximadas durante las importaciones normales. La serie ya está seleccionada y su identificador de TVmaze es explícito:
| Campo | Valor |
|---|---|
| Identificador de la serie en TVmaze | 216 |
| Nombre de la serie | Rick and Morty |
| URL de la serie | https://www.tvmaze.com/shows/216/rick-and-morty |
El plugin puede cargar:
https://api.tvmaze.com/shows/216/episodes
Y construir una tabla de consulta por temporada y número de episodio. Así, cada fila de Rick and Morty llega al proceso enriquecida con:
process:
  tvmaze_id: tvmaze_id
  tvmaze_url: tvmaze_url
  rating_average: rating_average
  rating_source: rating_source
Fíjate en la clave de unión: temporada y número de episodio, no el título. Los títulos dependen demasiado de decisiones editoriales para ser claves seguras. Los cambios de puntuación, los títulos alternativos y las pequeñas diferencias de redacción pueden generar fallos que parecen inocentes durante demasiado tiempo.
La asociación queda así:
Rick and Morty API: S01E01
season: 1
episode_number: 1
TVmaze show: 216
TVmaze episode: season 1, number 1
Obtenemos puntuaciones mientras la API de Rick and Morty sigue siendo responsable de la identidad del episodio.
Fandom enriquece entidades existentes
Fandom es otra clase de fuente. Es rica, útil y editorial, pero también desordenada, como corresponde a una wiki. Los resultados de búsqueda pueden ser ambiguos, los títulos de las páginas pueden diferir de los nombres de la API y un episodio llamado Pilot no es precisamente una expresión única en Internet.
Por eso las migraciones de Fandom se ejecutan después de crear las entidades básicas:
rick_and_migraty_character_fandom
rick_and_migraty_location_fandom
rick_and_migraty_episode_fandom
Actualizan entidades existentes de Drupal. No crean registros canónicos nuevos.
El plugin de origen rick_and_migraty_fandom parte de las entidades de Drupal, resuelve una página de Fandom mediante un identificador explícito, un alias o una búsqueda exacta, lee la API de MediaWiki, extrae texto descriptivo útil y produce filas que contienen el identificador de la entidad existente y los metadatos de Fandom.
La migración de enriquecimiento de personajes es un ejemplo compacto:
| |
Source: Archivo fuente en GitLab
El plugin está en RickAndMigratyFandom.php. Utiliza dos servicios de apoyo: FandomClient.php, para las peticiones a MediaWiki con caché, y FandomDescriptionExtractor.php, para convertir el HTML interpretado de la wiki en párrafos introductorios legibles.
El destino sigue siendo el mismo tipo de entidad:
destination:
  plugin: 'entity:rick_and_migraty_character'
Y las asignaciones actualizan los campos de enriquecimiento:
process:
  id: entity_id
  fandom_description: fandom_description
  fandom_page_id: fandom_page_id
  fandom_url: fandom_url
  fandom_source: fandom_source
La regla es deliberadamente conservadora: si la coincidencia es ambigua, se omite y se registra. Es más fácil corregir una descripción ausente que una equivocada que parece fiable.
El YAML hace visible ese contrato. Las entradas explícitas de page_id_map permiten fijar casos difíciles conocidos. aliases ayuda cuando el título de Fandom no coincide con la etiqueta de la API. La búsqueda exacta resuelve los casos sencillos. Y el destino sigue apuntando a la entidad personalizada existente mediante id: entity_id, por lo que el enriquecimiento llega al registro ya importado.
9. De los datos al contenido (navegar)
Una migración no termina cuando hay filas en las tablas. Se vuelve útil cuando las personas pueden recorrer, consultar y entender los datos importados.
Por eso importa el modelo de entidades. Una vez que personajes, localizaciones y episodios existen como entidades reales de Drupal, el sitio puede exponerlos como páginas, rutas, Views y navegación basada en relaciones.
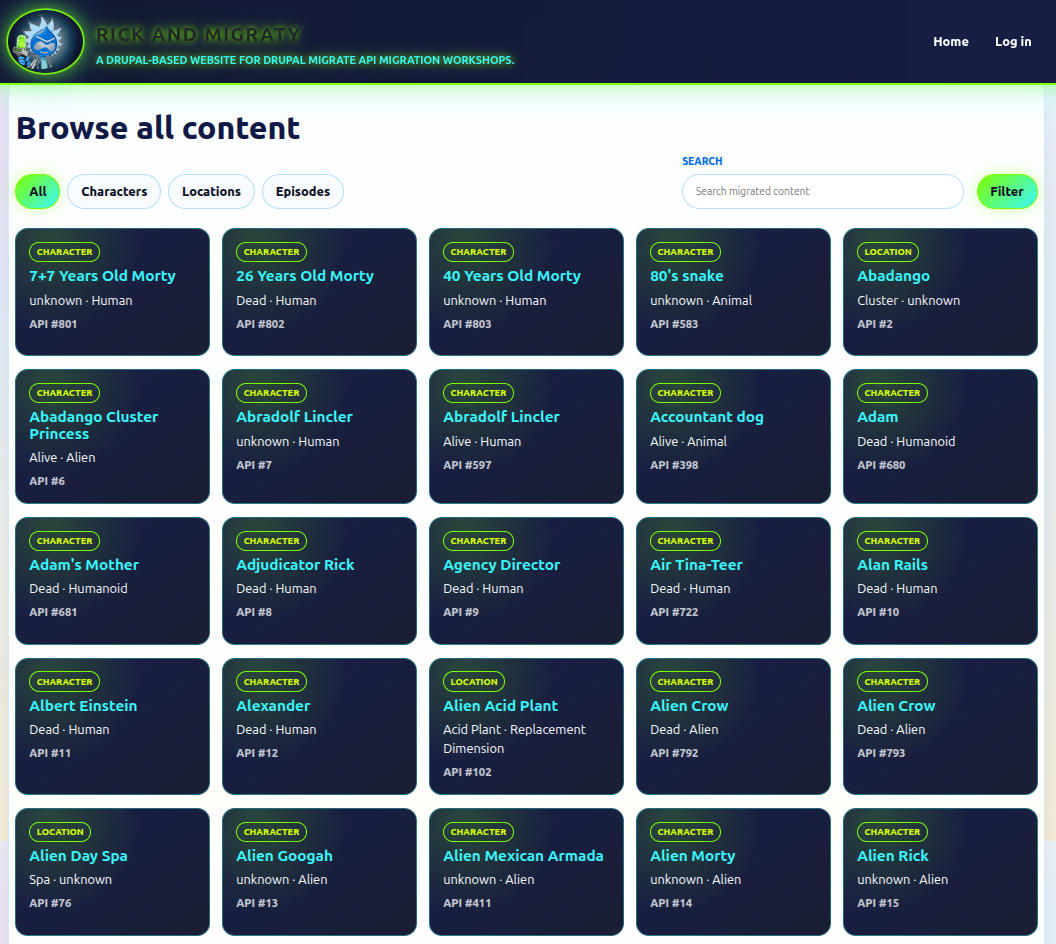 Listado completo con filtros y cuadro de búsqueda
En una página de personaje, las preguntas útiles son inmediatas:
- ¿Quién es este personaje?
- ¿Cuál es su estado, especie y género?
- ¿De dónde procede?
- ¿Dónde fue visto por última vez?
- ¿En qué episodios aparece?
- ¿Qué contexto adicional aporta Fandom?
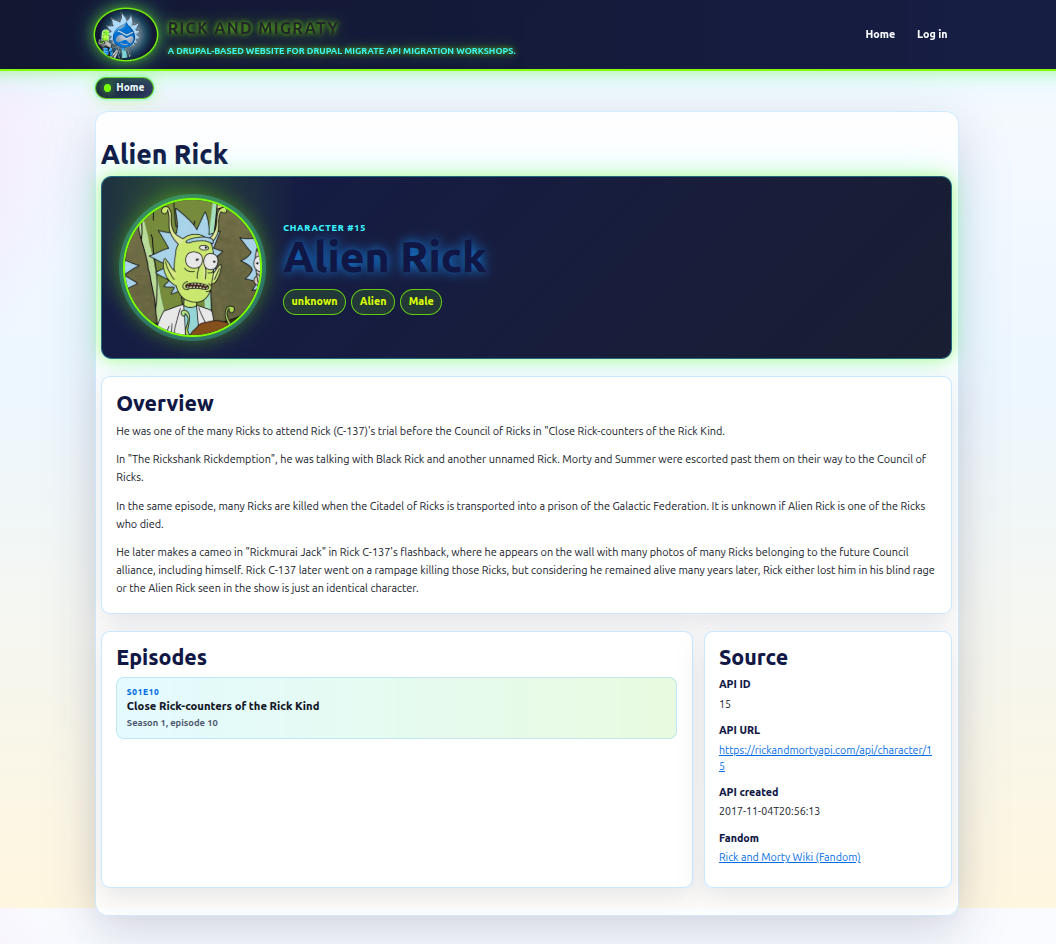 Ejemplo de personaje: Alien Rick
Para una localización, las preguntas cambian:
- ¿Qué clase de lugar es?
- ¿A qué dimensión pertenece?
- ¿Qué personajes residen allí?
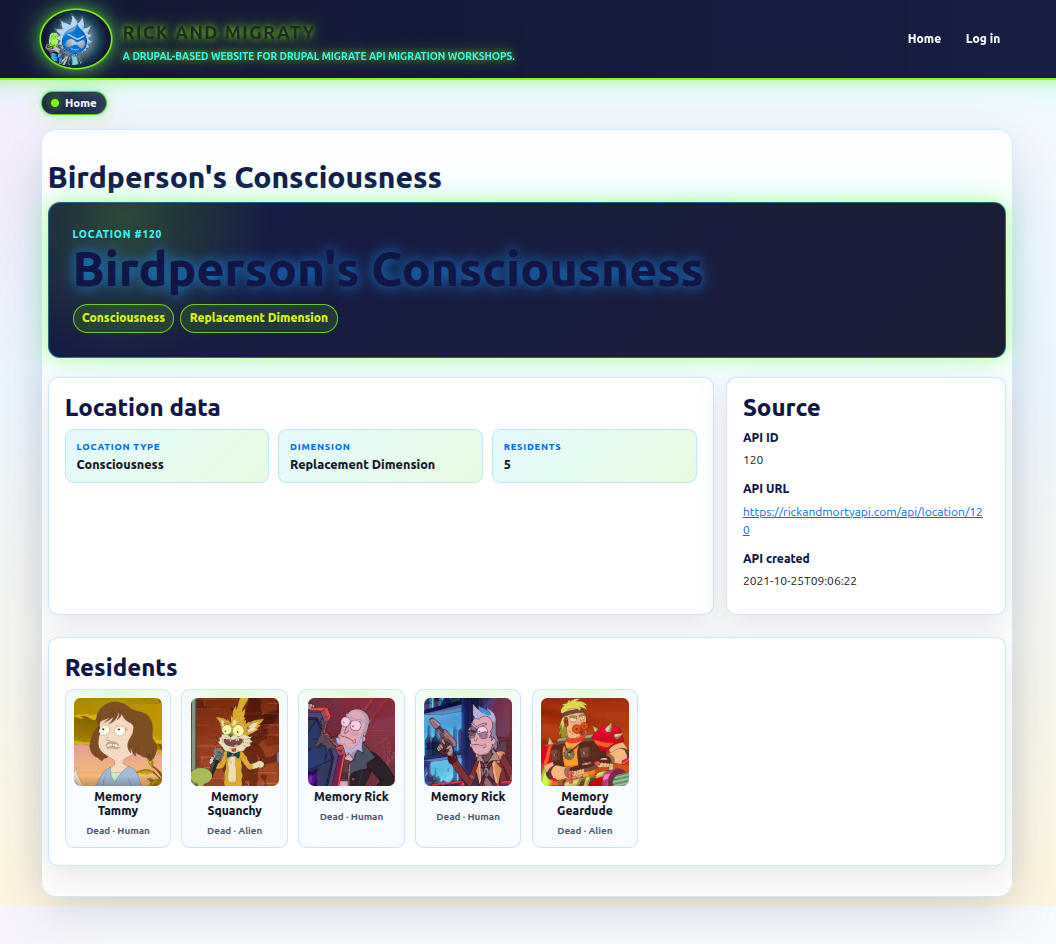 Ejemplo de localización: los recuerdos de Birdperson
Y para un episodio:
- ¿A qué temporada pertenece y qué número tiene?
- ¿Cuándo se emitió?
- ¿Qué puntuación ofrece TVmaze?
- ¿Qué personajes aparecen?
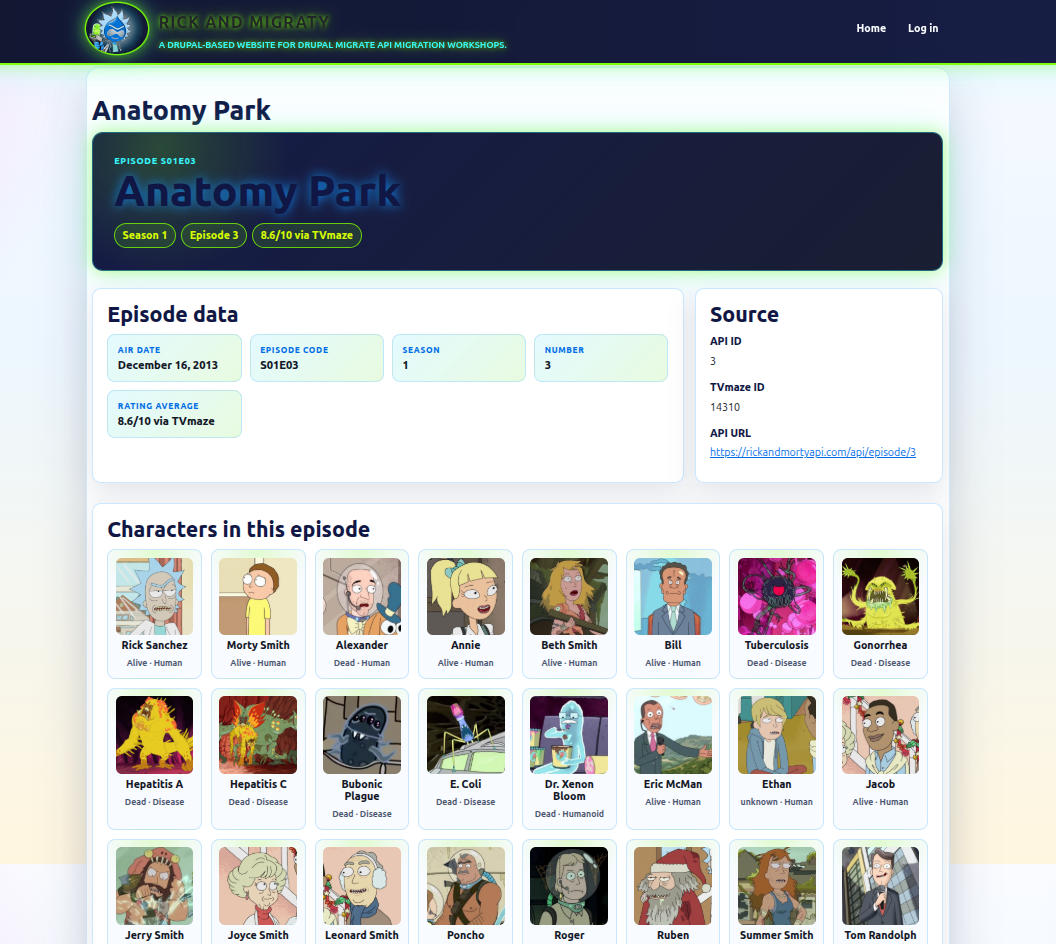 Página del episodio Anatomy Park
Los mismos datos pueden convertirse en vistas: personajes por dimensión, episodios por temporada, localizaciones con muchos residentes o un pequeño explorador de personajes por estado. Aquí la migración deja de ser un ejercicio de backend y se convierte en un producto de contenido.
Las plantillas del tema muestran esa idea:
rick-and-migraty-character.html.twigmuestra las insignias del perfil, el avatar, la descripción de Fandom, los enlaces a episodios y los metadatos de origen.rick-and-migraty-location.html.twigmuestra los metadatos de la localización, sus residentes y el contexto de Fandom.rick-and-migraty-episode.html.twigmuestra temporada y episodio, las insignias de puntuación de TVmaze y las apariciones de personajes.
La migración no se limita a rellenar campos: alimenta una experiencia de navegación. Los campos elegidos se convierten en variables que el tema puede utilizar: avatar_url, episode_links, resident_cards, appearance_cards, fandom.description, profile.api_url, etc.
El proyecto también incluye una ruta de exploración:
rick_and_migraty_migrate.browse:
  path: '/browse-all-content'
  defaults:
    _controller: '\Drupal\rick_and_migraty_migrate\Controller\BrowseContentController::browse'
    _title: 'Browse all content'
  requirements:
    _access: 'TRUE'
Su controlador, BrowseContentController.php, hace dos cosas interesantes para este artículo. Primero, ofrece una matriz de entidades importadas con búsqueda mediante /browse-all-content. Segundo, expone pasos de migración y puntos de consulta de estado visibles desde el navegador, para mostrar la importación como una operación y no solo como un comando de terminal.
Esto explica también por qué reducir todo a campos de texto habría sido un mal atajo. Lo interesante del conjunto de datos es el grafo. Los personajes enlazan a episodios, estos vuelven a enlazar a personajes, las localizaciones enumeran residentes y los campos de enriquecimiento añaden contexto sin quitarle la identidad a la fuente canónica.
10. La migración como operación (ejecutar)
La implementación es una mitad de la migración. La operación es la otra mitad.
Esto resulta especialmente cierto cuando intervienen varios servicios remotos, se descargan archivos, se enriquecen entidades en pasadas posteriores y debemos repetir el proceso durante el desarrollo. Llegados ahí, necesitamos algo más que definiciones YAML: puntos de entrada repetibles.
El proyecto admite varias formas de ejecución, cada una con su finalidad:
| Punto de entrada | Uso más adecuado |
|---|---|
scripts/rick-and-migraty-migrate.sh | Ejecuciones locales repetibles, especialmente con archivos de prueba. |
ddev drush ramt:migrate:* | Operaciones de desarrollo: reinicio, importación y lotes de avatares. |
| Ventana modal del navegador | Panel visual para ejecutar y observar la migración paso a paso. |
El script está en scripts/rick-and-migraty-migrate.sh. Es el ejecutor local de más alto nivel: reconstruye cachés, elimina opcionalmente el contenido importado anterior, elige entre archivos locales y llamadas reales, importa el contenido básico, genera alias, ejecuta el enriquecimiento de Fandom e imprime los recuentos de validación.
Para una ejecución local con archivos de prueba existentes:
scripts/rick-and-migraty-migrate.sh --fixtures
Si primero hay que generarlos:
scripts/rick-and-migraty-migrate.sh --build-fixtures
Estos archivos viven en:
.ddev/.tmp-fixtures/rick-and-migraty-api
Permiten leer las filas JSON canónicas de Rick and Morty desde archivos locales estables, en lugar de hacerlo desde la API pública. Así separamos dos problemas que de otro modo se mezclan:
- ¿Está fallando el código de la migración?
- ¿O el servicio remoto está lento, limita peticiones, no está disponible o ha cambiado?
Para comprobar la estructura más deprisa, podemos omitir las fases costosas:
scripts/rick-and-migraty-migrate.sh --fixtures --no-avatars --no-fandom
El ciclo normal con Drush es intencionadamente breve:
ddev drush ramt:migrate:reset
ddev drush ramt:migrate:import
Estos comandos se implementan en RickAndMigratyMigrateCommands.php. La utilidad de importación sigue el orden diseñado: localizaciones, episodios, avatares, personajes, actualización de relaciones de episodios y actualización de relaciones de localizaciones.
El comando de reinicio es importante. Limpia las entidades importadas, las entidades de archivo de avatares, sus archivos físicos, los alias y las filas de correspondencias y mensajes de Migrate. Esto último importa porque borrar entidades desde la interfaz no limpia el seguimiento interno de la API Migrate. Drupal puede parecer vacío mientras migrate:status sigue considerando importadas las filas.
La limpieza se delega en MigrationResetter.php, que hace explícita la operación: eliminar entidades personalizadas, entidades de archivo y archivos físicos de avatares, borrar alias /rick-and-migraty/%, vaciar tablas migrate_map_* y migrate_message_* e invalidar cachés.
Las descargas de avatares se gestionan como una operación propia:
ddev drush ramt:migrate:avatars --batch-size=10 --sleep=12 --retries=3
La forma del comando refleja la naturaleza del trabajo. Descargar cientos de archivos remotos no equivale a asignar campos JSON: requiere lotes, reintentos y pausas. La utilidad importa avatares mediante rangos --idlist, añade una pausa local entre peticiones y reintenta los lotes fallidos antes de rendirse.
La separación ofrece una vía de recuperación práctica: si las descargas fallan a mitad del proceso, podemos repetir la fase de archivos sin dar por roto todo el modelo de migración.
Los límites de peticiones forman parte del diseño
Durante el desarrollo apareció un recordatorio muy concreto de que las API remotas no son infinitas: respuestas 429 Too Many Requests. Es fácil considerarlas una molestia, pero en una migración aportan información útil. Nos dicen que pedimos demasiado, demasiado deprisa o demasiadas veces a un servicio que no controlamos.
La respuesta no fue ocultar el error, sino convertir el límite de peticiones en una restricción de diseño:
- Las respuestas se almacenan en caché por URL para no pedir las mismas páginas en cada ejecución.
- Los archivos de prueba pueden sustituir las llamadas remotas cuando comprobamos la lógica de asignación.
RICK_AND_MIGRATY_API_MAX_PAGESlimita las pruebas básicas a un subconjunto pequeño.request_delay_msralentiza las peticiones que no tienen respuesta en caché.- Las descargas de avatares se ejecutan por lotes con
--sleepy--retries. - Las importaciones de avatares usan rangos
--idlist, de modo que podemos repetir un lote fallido sin repetir toda la migración.
Por eso la fase de avatares tiene su propia secuencia y no queda escondida dentro de la importación de personajes. Las descargas remotas son la parte más agresiva del proceso: cientos de peticiones HTTP, transferencias binarias, entidades de archivo locales, escrituras en disco y reintentos. Separarlas hace la migración más respetuosa y mucho más fácil de recuperar.
Dicho de otro modo: el 429 no fue solo un código de error; fue una revisión de diseño enviada por la API remota.
El navegador es un panel de control
El flujo del navegador resulta útil, pero no debería pretender ser el motor de migración.
La primera versión intentó realizar demasiado trabajo en una petición larga. Eso es frágil, porque PHP-FPM, nginx, los proxies y los navegadores tienen sus propias opiniones sobre las peticiones HTTP prolongadas, y ninguna es sentimental. 😉
El flujo actual utiliza pasos POST más pequeños:
/rick-and-migraty/run-migration-step/{step}
La ruta se declara en rick_and_migraty_migrate.routing.yml y la gestiona BrowseContentController.php.
Esta es la ventana modal:
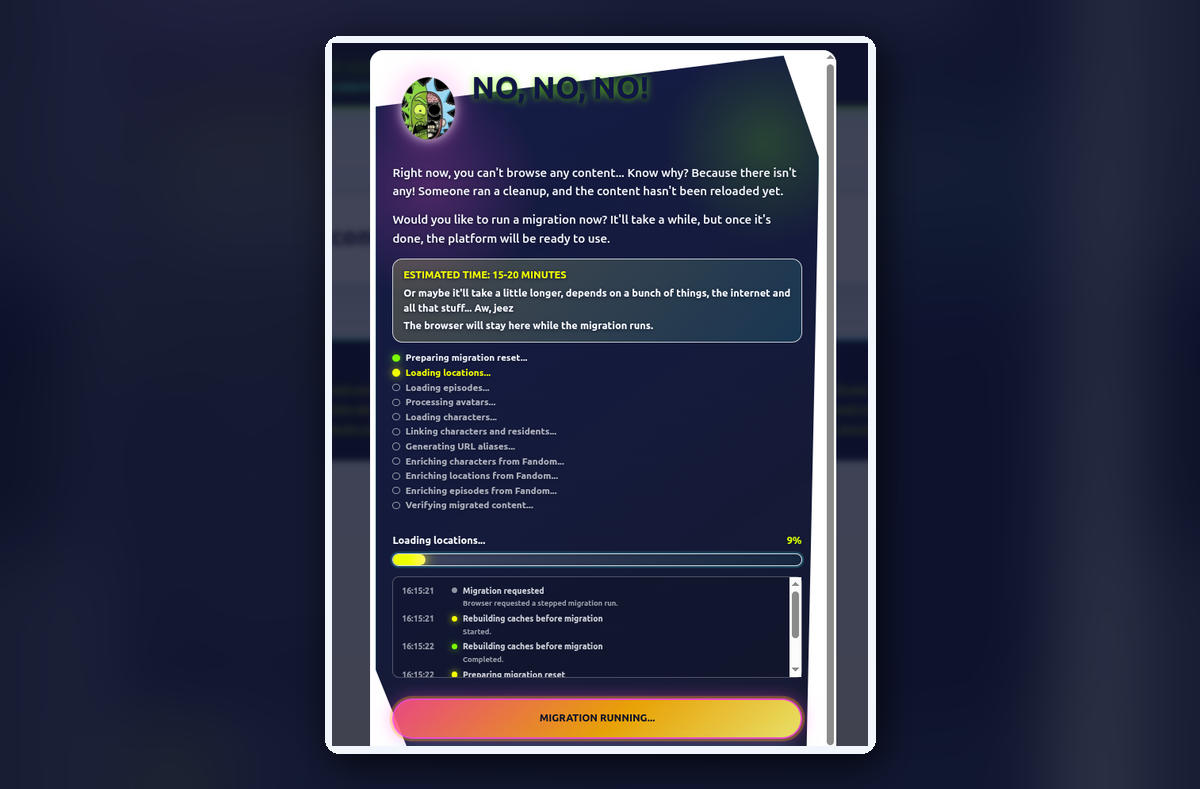 Progreso y trazas de la migración en la ventana modal
Muestra el progreso, las trazas recientes y un resumen final. La misma traza se escribe en watchdog mediante el canal rick_and_migraty_migrate, de modo que un síntoma observado en el navegador puede investigarse con Drush:
ddev drush watchdog:show --type=rick_and_migraty_migrate --count=50
El trabajo de avatares se divide internamente en rangos como avatars-1, avatars-2, etc. El usuario ve una sola fase, «Procesando avatares», pero el backend recibe unidades de trabajo más pequeñas cuyos fallos, registros y recuperación son más claros.
La distinción importa: el navegador no sustituye a Drush. Es un panel guiado sobre los mismos pasos operativos, útil para observar el proceso y hacer visible la experiencia de migración.
11. Perder la cabeza (depurar)
Cuando falla una migración, resulta tentador mirar fijamente el YAML hasta que confiese. A veces funciona. A menudo solo conseguimos poner nervioso al YAML. 😬
Una rutina mejor es depurar de fuera hacia dentro.
- Primero, inspecciona el origen:
curl -s 'https://rickandmortyapi.com/api/character' | jq '.info'
curl -s 'https://rickandmortyapi.com/api/character' | jq '.results[0]'
curl -s 'https://rickandmortyapi.com/api/location' | jq '.results[0].residents'
curl -s 'https://rickandmortyapi.com/api/episode' | jq '.results[0].characters'
curl -s 'https://api.tvmaze.com/shows/216/episodes' | jq '.[0] | {id, name, season, number, rating}'
Todavía no pretendemos depurar Drupal. Antes hay que responder una pregunta más sencilla: ¿la fuente sigue teniendo la estructura que espera la migración? Si ha cambiado o un punto de acceso está lento o caído, el YAML no es el primer sospechoso.
- Después, inspecciona el estado de la migración:
ddev drush migrate:status
ddev drush migrate:messages rick_and_migraty_location
ddev drush migrate:messages rick_and_migraty_episode
ddev drush migrate:messages rick_and_migraty_character
migrate:status indica qué cree Drupal que se ha importado. Las tablas de mensajes explican qué filas fallaron y por qué. Aquí cobra sentido lo explicado sobre el reinicio: el estado de la API Migrate no equivale al contenido visible.
Si faltan relaciones inversas tras una ejecución parcial, repite directamente las pasadas de actualización:
ddev drush migrate:import rick_and_migraty_episode --update
ddev drush migrate:import rick_and_migraty_location --update
Estos comandos tienen un alcance limitado a propósito. No vuelven a descargar avatares, reconstruir archivos de prueba ni importar todo el grafo. Solo piden a las migraciones ya definidas que completen relaciones cuyos personajes de destino ahora sí pueden resolverse.
Si el problema está en el enriquecimiento de Fandom, depura esa fase sin repetir las importaciones básicas:
ddev drush migrate:messages rick_and_migraty_character_fandom
ddev drush migrate:messages rick_and_migraty_location_fandom
ddev drush migrate:messages rick_and_migraty_episode_fandom
Y repite únicamente las migraciones de enriquecimiento:
ddev drush migrate:import rick_and_migraty_character_fandom --update --feedback=50
ddev drush migrate:import rick_and_migraty_location_fandom --update --feedback=25
ddev drush migrate:import rick_and_migraty_episode_fandom --update --feedback=25
Esta es otra razón para ejecutar el enriquecimiento por separado. Un problema de análisis de Fandom no debería obligarnos a importar de nuevo todo el contenido canónico. El grafo básico y el enriquecimiento editorial son ámbitos de depuración distintos.
Cuando una fila se resiste, la lista de comprobación resulta familiar:
- Revisa la indentación del YAML.
- Inspecciona los selectores del origen.
- Inspecciona las tablas
migrate_map_*. - Inspecciona las tablas
migrate_message_*. - Confirma que las dependencias se ejecutaron en el orden esperado.
- Utiliza Xdebug en DDEV cuando sospeches de un plugin de proceso personalizado.
Para este proyecto añadiría unas comprobaciones:
- Confirma
RICK_AND_MIGRATY_API_FIXTURE_BASE_PATHsi utilizas archivos de prueba. - Confirma que
RICK_AND_MIGRATY_API_MAX_PAGESno limita inesperadamente la ejecución. - Inspecciona las entradas de watchdog de
rick_and_migraty_migrate. - Determina si la fila fallida pertenece a la importación básica, la descarga de avatares, la cumplimentación de relaciones o el enriquecimiento de Fandom.
En los lugares aburridos suelen estar las pistas útiles: un selector, una tabla de correspondencias, una dependencia ausente, una cadena vacía o un valor que parecía un entero hasta que conoció los datos reales.
12. Decisiones que merece la pena destacar (decidir)
Hay varias decisiones que conviene documentar porque determinan la implementación más que cualquier YAML individual. Si alguien retoma el proyecto más adelante, me gustaría que las conociera antes de modificar las migraciones.
En primer lugar, las relaciones circulares son previsibles. Los personajes apuntan a localizaciones y episodios, y estos vuelven a apuntar a personajes. No intentamos resolverlo todo de una pasada heroica: primero importamos el grafo básico y después completamos las referencias inversas mediante actualizaciones.
En segundo lugar, la paginación forma parte del contrato del origen. Si una migración solo importa la primera página, no es una migración: es una demostración que se ha cansado. El plugin de origen se encarga de paginar porque todos los recursos canónicos necesitan el mismo comportamiento y al YAML no debería importarle cuántas páginas tiene hoy la API.
En tercer lugar, los identificadores externos no son opcionales. El
idde origen se guarda comoapi_idy se utiliza como puente estable entre registros remotos, tablas de correspondencias, archivos de prueba, actualizaciones y depuración. Los identificadores de entidad de Drupal son detalles locales de implementación; el de la API es la identidad que podemos explicar.En cuarto lugar, las imágenes merecen su propia fase. Los avatares se descargan mediante una migración separada y pueden procesarse por lotes. La entidad conserva
image_url, pero gestionar archivos locales es una operación distinta de asignar campos y debe tratarse como tal.En quinto lugar, debemos tratar con consideración a las API públicas. La caché, los archivos de prueba, los límites de páginas y las pausas no son adornos. Los errores
429 Too Many Requestslo dejaron claro: la consideración no es solo una cuestión de educación; hace posible repetir la migración.Por último, las fuentes de enriquecimiento no son fuentes canónicas. TVmaze aporta puntuaciones. Fandom aporta descripciones. Ninguna puede redefinir el conjunto básico de Rick and Morty.
La lista no es solo documentación: también protege el diseño. Cuando el proyecto crezca, cada nueva migración debería contrastarse con estas decisiones:
- ¿Conserva la autoridad de cada fuente?
- ¿Mantiene explícitas las relaciones?
- ¿Sigue siendo repetible?
- ¿Evita que los servicios remotos se conviertan en un peaje constante para desarrollar?
13. Qué he aprendido (reflexionar)
Si tuviera que extraer algunos principios reutilizables de la experiencia Rick and Migraty, serían estos.
Elabora un perfil de la fuente antes de escribir demasiado YAML. Conoce sus páginas, campos, valores vacíos, formas de relación y casos difíciles antes de dar por evidente el modelo de Drupal. No hace falta un documento formal, pero sí responder preguntas prácticas: dónde están los identificadores, las relaciones, las fechas, los archivos y los valores vacíos, y qué campos son meras etiquetas de presentación.
Conserva el grafo cuando el valor está en el grafo. Personajes, localizaciones y episodios no son simplemente tres listas. Lo interesante son sus relaciones, así que el modelo de destino debe permitir consultarlas. Si las aplana hasta convertirlas en texto, la migración puede tener éxito técnico y, al mismo tiempo, perder el sentido del conjunto de datos.
Mantén acotadas las transformaciones. Un plugin extrae identificadores de URL. Otro obtiene la temporada o el episodio. Un plugin de origen se ocupa de la paginación. Las piezas pequeñas son más fáciles de explicar, probar y sustituir. Además, hacen el YAML más legible porque cada nombre expresa una intención.
Ordena las importaciones deliberadamente. Las localizaciones y los episodios deben existir antes de que los personajes puedan referenciarlos. Los personajes deben existir antes de completar las relaciones inversas. El orden no es un detalle de implementación, sino parte del modelo. Si resulta incómodo, probablemente el grafo está intentando decirnos algo.
Considera las operaciones parte del diseño. Reinicios, archivos de prueba, lotes de avatares, actualizaciones y trazas en el navegador no son extras simpáticos. Son lo que permite utilizar la migración después de la primera importación exitosa.
Y quizá lo más importante: no permitas que las fuentes secundarias difuminen el contrato. Podemos combinar datos de varios lugares sin volver ambiguo quién es responsable de cada información. Aquí, la API de Rick and Morty controla el grafo canónico; TVmaze enriquece las puntuaciones; y Fandom, el contexto narrativo.
Eso es lo que reutilizaría en otro proyecto aunque su temática fuera completamente distinta. Cambiarían los nombres, las API y los campos, pero se mantendría el patrón:
- Elegir la fuente canónica.
- Modelar el grafo.
- Aislar los enriquecimientos.
- Hacer que repetir la ejecución sea aburrido.
14. Próximos pasos (planificar)
Este proyecto ha reunido paginación, relaciones, enriquecimiento, avatares, archivos de prueba y ejecución repetible en una migración funcional de Drupal. Los próximos pasos parten de esa implementación:
- Mantener el artículo y la documentación de MkDocs alineados con el código a medida que evolucione el proyecto, actualizando ejemplos y capturas cuando cambie el comportamiento.
- Explorar la migración de avatares en otro artículo, porque la gestión de archivos remotos, los lotes y la recuperación merecen un examen más detallado.
- Revisar la cobertura del conjunto canónico y decidir cómo tratar episodios y personajes ausentes, conservando identificadores externos estables y responsabilidades explícitas de las fuentes.
También hay otro posible artículo a la vista: el panel de control del navegador. Conecta la ejecución, el estado de las trazas, la consulta periódica del progreso, los comandos Drush y la información que recibe el usuario. No forma parte estrictamente de la API Migrate, pero sí de conseguir que una migración resulte utilizable por personas.
Por ahora, lo importante es que el diseño sea visible. Tenemos una fuente canónica, un modelo de destino, un orden de importación por fases, plugins para problemas repetidos, pasadas de enriquecimiento, utilidades operativas y una rutina de depuración. Es suficiente para esta sexta parada de la serie.
Intentar incluir todos los detalles de implementación convertiría el artículo en un manual. La versión útil tiene un alcance más acotado: código suficiente para concretar el diseño, explicación suficiente para comprender los compromisos y detalle operativo suficiente para no fingir que las migraciones terminan cuando el YAML valida.
Nota sobre la documentación: La estructura y la intención de este artículo siguen los principios de Diátaxis, distinguiendo tutoriales, guías prácticas, explicaciones y material de referencia para situar las instrucciones y el contexto conceptual donde corresponden.
Nota sobre el idioma: Se utilizó asistencia de IA para revisar la gramática y pulir las expresiones del original inglés. Las decisiones técnicas, la implementación y la experiencia descrita siguen siendo propias del autor. Esta versión castellana también se ha preparado con asistencia de IA.
Comments
Los comentarios los proporciona Disqus. Solo se cargan si permites la categoría de comentarios en tus preferencias de cookies.